Bir toplantıda, röportajda veya podcast’te belirli bir bölümü bulmak için kaydın tamamını dinlemek gerekebilir. “Kim, ne söyledi?” sorusunun yanıtı kayıtta olsa da ona ulaşmak zaman alır. Bulut tabanlı servisler bu işi kolaylaştırır; ancak bunun için ses kaydını başka bir sunucuya yüklemeniz gerekir.
Speech Studio, bu işlemleri NVIDIA Jetson Orin Nano Developer Kit üzerinde, yerel olarak yapan açık kaynaklı bir araç. Ses kaydını yazıya döküyor, konuşmacıları ayırıyor, içeriği özetliyor ve kayıt hakkında sorularınızı yanıtlıyor. Ses dosyası bütün bu işlemler boyunca cihazda kalıyor.
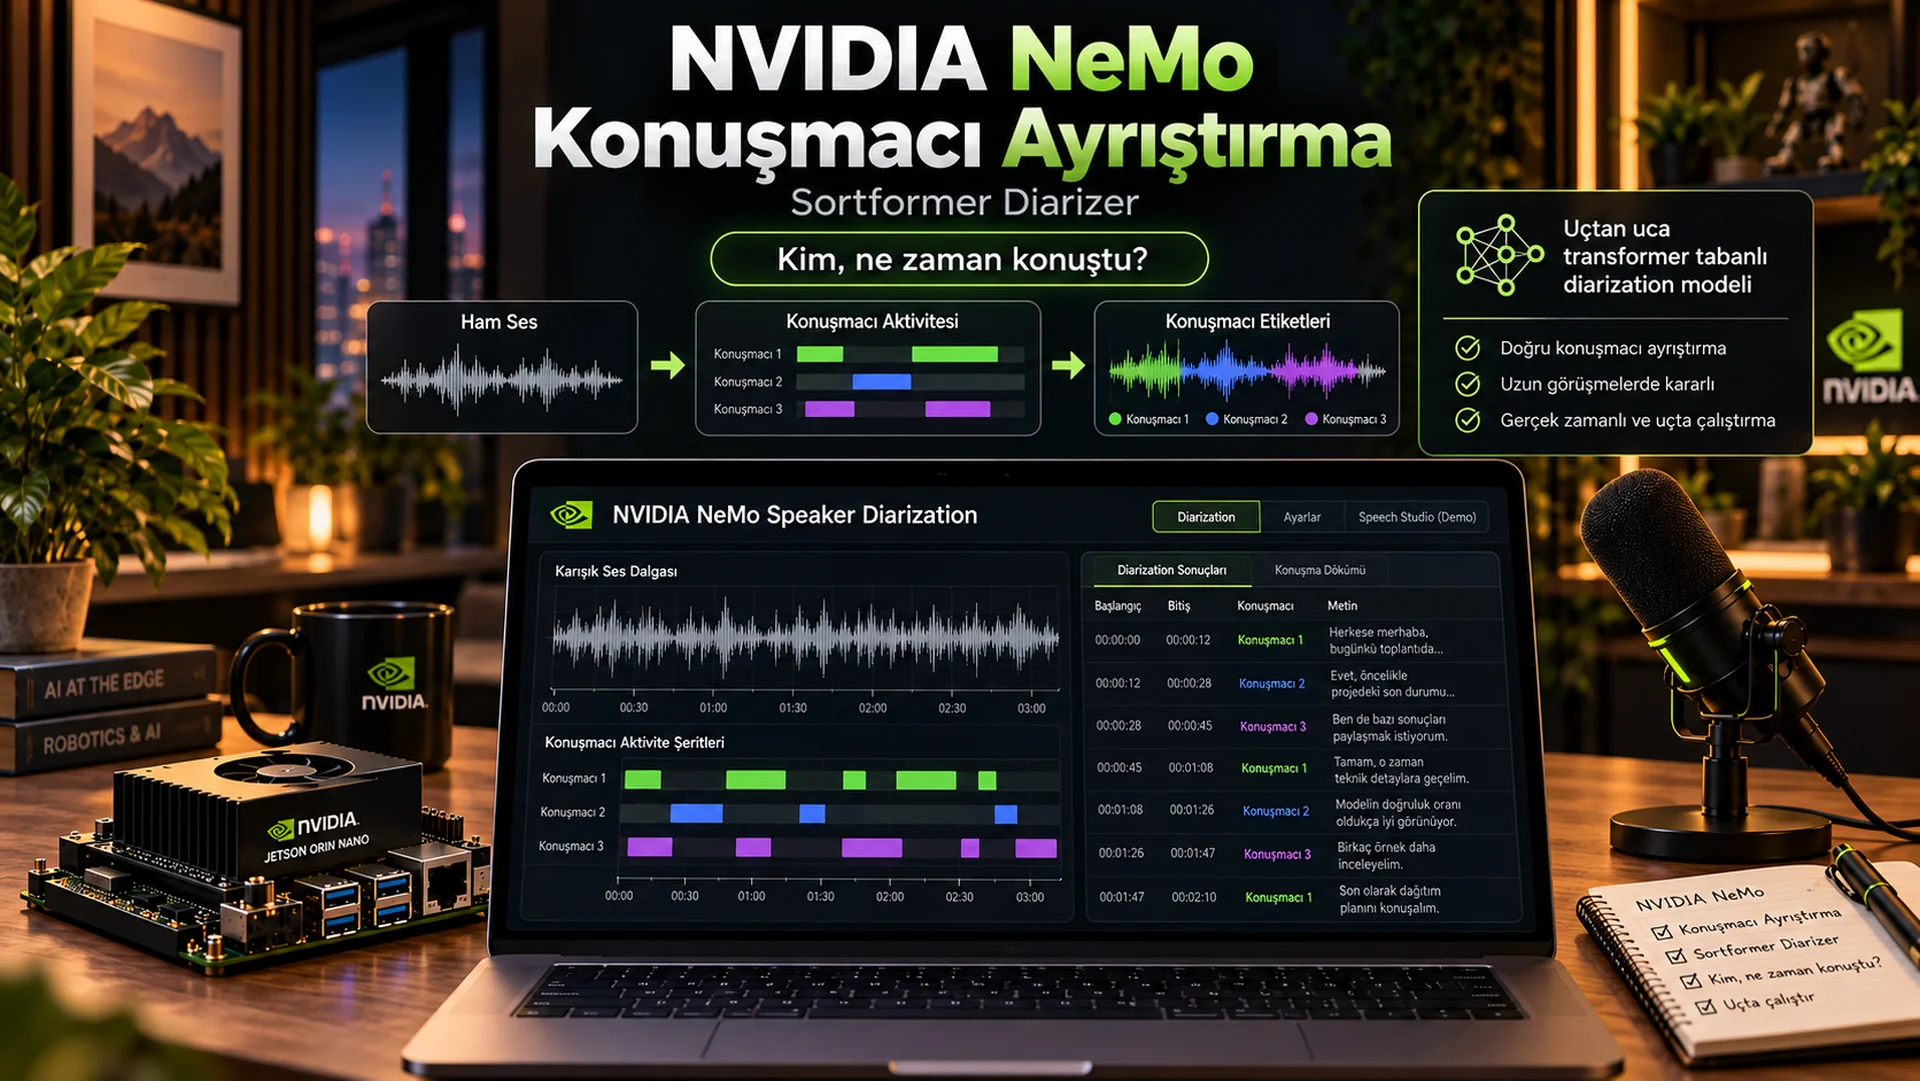
Uygulamanın merkezinde, NVIDIA’nın konuşmacı ayrımı modeli Nemotron-3-Diarization var. “Kim, ne zaman konuştu?” sorusunu yanıtlayan bu model, aşağıda ayrı bir bölümde anlatılıyor.
Projenin kaynak kodu GitHub’da: github.com/openzeka/speech-studio
Bu yazıdaki ölçümler ve ekran görüntüleri, 8 GB belleğe sahip bir NVIDIA Jetson Orin Nano Developer Kit üzerinde alındı.

Gerçek bir kayıtla deneme
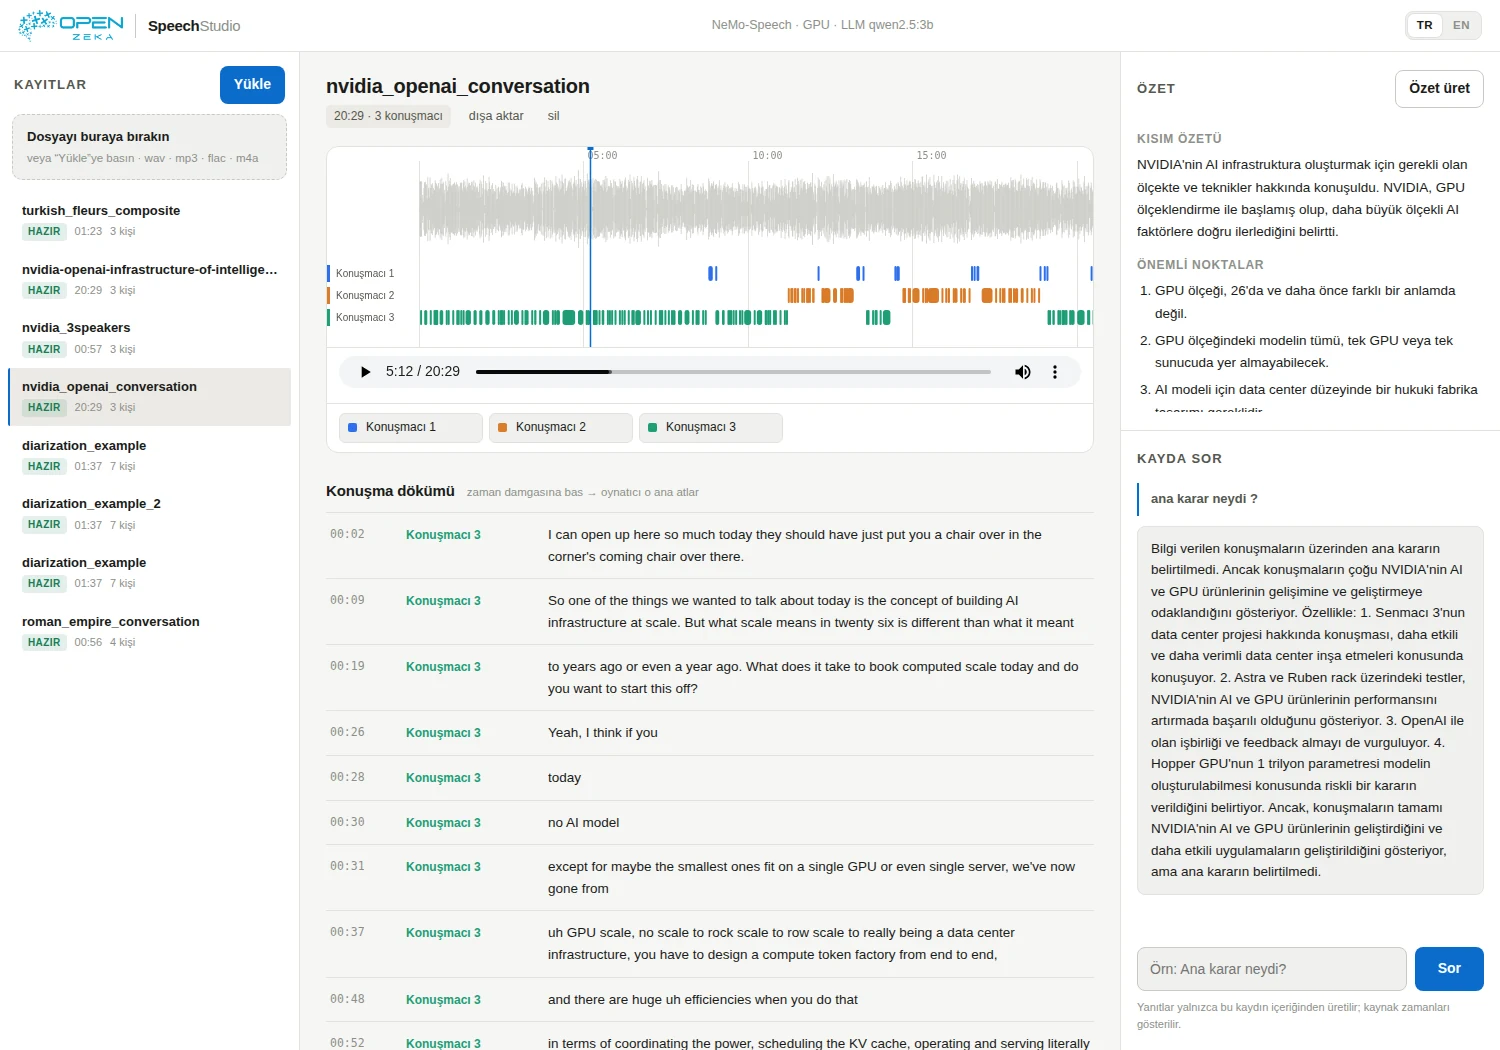
Denemelerde, NVIDIA ve OpenAI’nin yapay zekâ altyapısı üzerine yaptığı sohbetten alınan 20 dakika 30 saniyelik bir kayıt kullanıldı.
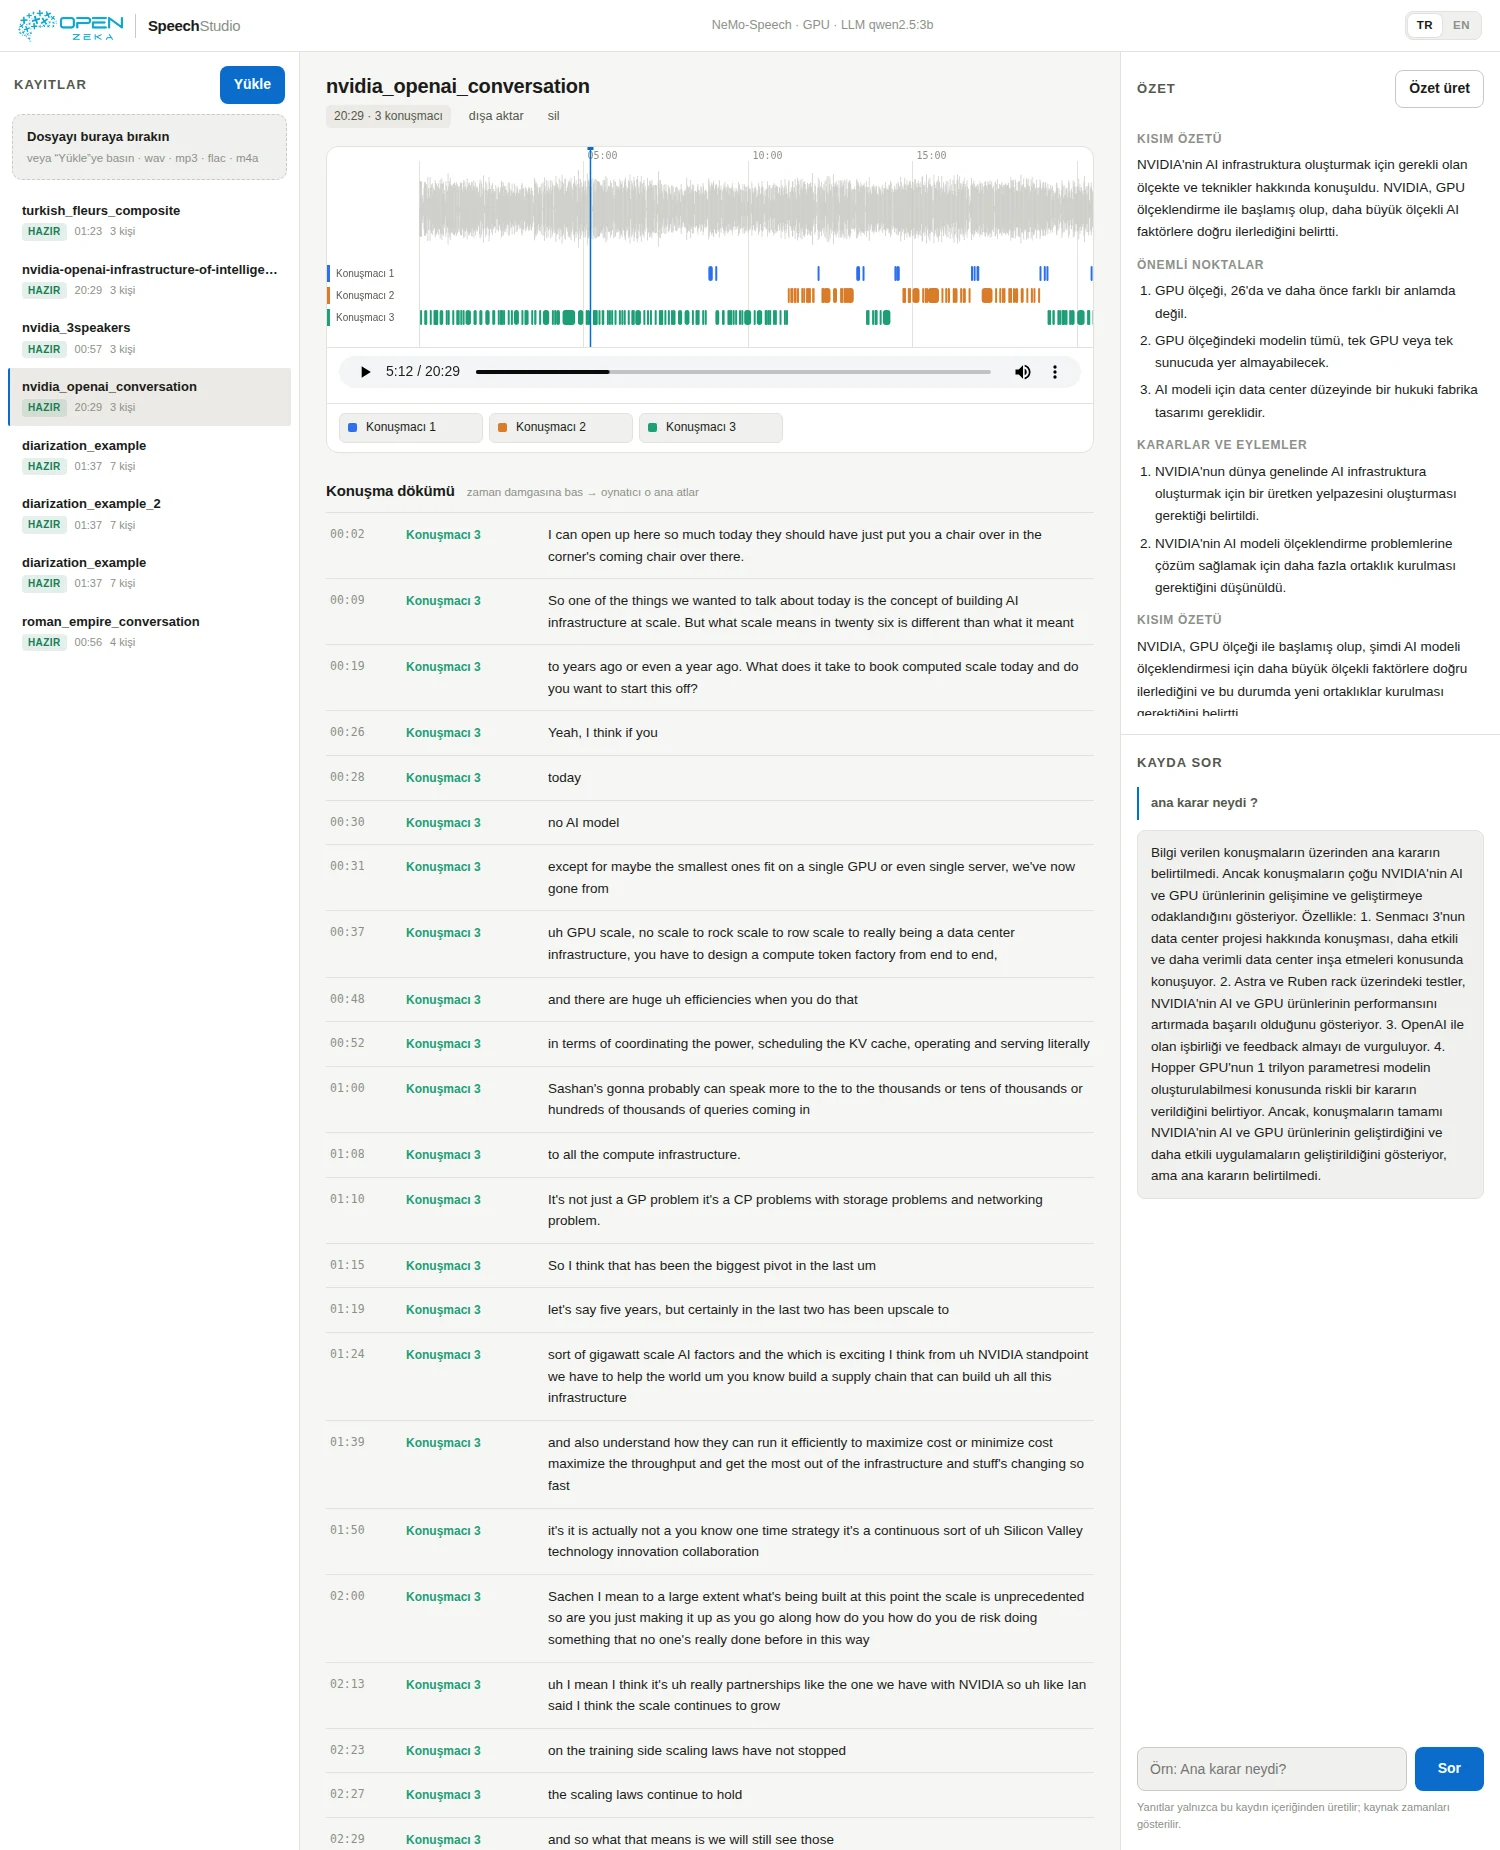
Speech Studio bu kayıtta 3 konuşmacı ve 187 konuşma bölümü tespit etti. Konuşmayı metne dönüştürürken her bölümü konuşmacısıyla ve zaman damgasıyla eşleştirdi:
[00:09] Konuşmacı 3: So one of the things we wanted to talk about today is the concept of building AI infrastructure at scale.
“Konuşmacı 3” gibi etiketler daha sonra kişinin adıyla değiştirilebiliyor. Uygulama ayrıca kaydın özetini, öne çıkan noktalarını ve alınan kararları çıkarıyor. Kayıt hakkında bir soru sorduğunuzda yanıtını ilgili zaman damgalarıyla birlikte gösteriyor.
Üretilen döküm ve özetler yapay zekâ çıktısı olduğu için hata içerebilir. Özellikle özel adlar yanlış yazılabilir. Zaman damgaları, önemli bilgileri özgün kayıttan kontrol etmeyi kolaylaştırıyor.
Konuşmacıları ayıran model: Nemotron-3-Diarization
Bir kayda sorulabilecek üç farklı soru
Ses üzerinde çalışan yapay zekâ modellerini, yanıtladıkları soruya göre ayırmak işleri kolaylaştırıyor:
- Konuşma tanıma (ASR) — Girdi: Ses, Çıktı: Metin — “Ne söylendi?”
- Metinden sese (TTS) — Girdi: Metin, Çıktı: Ses — “Bu metin nasıl seslendirilir?”
- Konuşmacı ayrımı (diarization) — Girdi: Ses, Çıktı: Konuşmacı zaman çizelgesi — “Kim, ne zaman konuştu?”
ASR bir zabıt kâtibi gibi çalışıyor: duyduğu her kelimeyi yazıya geçiriyor ama kelimeleri kimin söylediğini ayırt etmiyor. TTS ters yönde çalışıyor; metni alıp ona ses veriyor. Konuşmacı ayrımı ise ne metin ne de ses üretiyor. Ürettiği şey bir harita: “Birinci ses 00:00 ile 00:12 arasında konuştu, ikinci ses 00:12’de araya girdi, 00:30’da birinci ses geri döndü.”
Bunu yaparken kelimelerin anlamına bakmıyor; seslerin kendisini ayırt ediyor: tını, perde, konuşma biçimi. Kimin kim olduğunu da bilmiyor. “Ayşe” ya da “Mehmet” demiyor; yalnızca “bu ses, şu sesten farklı” diyor. İsimleri sonradan siz veriyorsunuz.
Hangi sorunu çözüyor?
Yalnızca ASR kullanırsanız, 20 dakikalık bir toplantının dökümü tek parça, uzun bir metin olarak gelir. İçinde “Bunu cuma gününe yetiştiririm” diye bir cümle var; ama bu sözü kim verdi? Hangi itiraz kimden geldi? Döküm bunu söylemiyor.
Konuşmacı ayrımı bu metni bir sohbete dönüştürüyor. Her cümle sahibine bağlanıyor; böylece kimin ne kadar konuştuğunu görebiliyor, bir kişinin söylediklerini art arda okuyabiliyor, kararları ve sözleri doğru kişiye atfedebiliyorsunuz. Özet ve soru-cevap da bu sayede “bunu kim önerdi?” gibi sorulara yanıt verebiliyor.
Neden zor bir iş?
Kulağa basit gelse de bu, konuşma işlemenin zor problemlerinden biri:
- Konuşmacılar önceden belli değil. Model kayıtta kaç kişi olduğunu da, kimin kim olduğunu da bilmeden başlıyor.
- İnsanlar aynı anda konuşuyor. Gerçek bir sohbette insanlar birbirinin sözünü kesiyor, “evet”, “hı hı” gibi kısa onaylarla araya giriyor.
- Sesler birbirine benzeyebiliyor. Aynı yaşta ve cinsiyette iki kişiyi ayırmak, belirgin farklı sesleri ayırmaktan çok daha zor.
- Tutarlılık gerekiyor. Birinci dakikada “Konuşmacı 2” olan kişi, yirminci dakikada geri döndüğünde yine “Konuşmacı 2” olmalı.
Model içeride nasıl çalışıyor?
Klasik sistemler bu işi birbirine bağlı birkaç adımla yapıyor: önce konuşma olan bölümleri buluyor, sonra her bölümden bir “ses izi” çıkarıyor, en sonda da bu izleri benzerliklerine göre gruplara ayırıyor. Her adım bir öncekinin hatasını devralıyor. Üst üste binen konuşmalar da bu yapıya pek uymuyor; bir bölüme genellikle tek bir konuşmacı atanıyor.
Nemotron-3-Diarization, NVIDIA’nın Sortformer ailesinden, işi tek seferde yapan bir model. Kaydı çok kısa zaman dilimleri hâlinde dinliyor ve her dilim için sekiz soruya aynı anda yanıt veriyor: “Birinci konuşmacı şu an konuşuyor mu? İkinci? …” Sonuç, her konuşmacı için ayrı bir şeridi olan, sekiz şeritli bir kayıt makinesine benziyor. Aynı anda birden fazla şerit dolu olabildiği için iki kişinin üst üste konuştuğu anlar da doğal olarak işaretleniyor. Speech Studio’daki renkli zaman çizelgesi, bu şeritlerin görünür hâli.
Bu tür modellerin bilinen bir sorunu, etiketlerin sırasının belirsiz olması. Model iki farklı sesi doğru ayırsa bile hangisine “1”, hangisine “2” diyeceği keyfidir; bu da hem eğitimi hem tutarlılığı zorlaştırır. Sortformer bunu basit bir kuralla çözüyor: kayıtta ilk konuşan “1”, ikinci olarak katılan “2” olur. (Speech Studio’nun gösterdiği numaralar bu sırayı her zaman izlemiyor: örnek kayıtta ilk konuşan kişi “Konuşmacı 3” olarak etiketlendi. Etiketler zaten arayüzden kişilerin adlarıyla değiştirilebiliyor.)
Model canlı ses üzerinde de çalışabiliyor. Bu modda, daha önce duyduğu konuşmacıları küçük bir hafızada (Arrival-Order Speaker Cache) tutuyor; böylece birisi dakikalar sonra yeniden konuştuğunda onu tanıyıp aynı etiketi veriyor. Gecikme 0,32 saniyeye kadar indirilebiliyor.
Nasıl eğitilmiş, ne kadar başarılı?
Model, yaklaşık 10.000 saat gerçek konuşma ve 82.611 saat yapay olarak oluşturulmuş çok konuşmacılı ses ile eğitilmiş. Yapay karışımlar özellikle önemli: farklı kayıtlar üst üste bindirilerek modele, insanların sözünün kesildiği, aynı anda konuşulduğu durumlar bolca gösterilmiş. Eğitim verisi İngilizce, Mandarin Çincesi ve Hint dilleri başta olmak üzere birçok dili kapsıyor.
Başarı, Diarization Error Rate (DER) ile ölçülüyor: kaçırılan konuşma, olmayan yerde konuşma algılanması ve konuşmanın yanlış kişiye atanması, toplam sürenin yüzdesi olarak. Düşük değer daha iyi. NVIDIA’nın model kartında yayımladığı sonuçlar:
- NOTSOFAR1 — toplantı kayıtları — DER %6,77
- CALLHOME (Part 2) — telefon görüşmeleri — DER %9,10
- DIHARD III — farklı alanlardan zorlu kayıtlar — DER %12,73
Bu sonuçlar kaydın tamamını işleyen modda alınmış. Canlı akışta, en düşük gecikmede (0,32 sn) bile DIHARD III’teki hata %13,55’te kalıyor.
Bütün bunları yaklaşık 100 milyon parametreyle yapıyor; bu, bugünün dil modellerinin yanında çok küçük. Bu sayede 8 GB bellekli Orin Nano’da konuşma tanıma ve özetleme modelleriyle birlikte çalışabiliyor. Model en fazla 8 konuşmacıyı ayırt ediyor ve OpenMDW 1.1 lisansıyla ticari kullanıma da açık.
Speech Studio’da nasıl kullanılıyor?
Speech Studio iki modeli yan yana çalıştırıyor. ASR her kelimeyi zaman damgasıyla yazıya döküyor; Nemotron-3-Diarization aynı zaman aralığında kimin konuştuğunu söylüyor. Bu iki bilgi birleşince her kelime sahibine bağlanıyor. Speech Studio da aynı kişinin art arda söylediği kelimeleri konuşma turlarında topluyor; zaman çizelgesi, döküm, özet ve soru-cevap bu turların üzerine kuruluyor. Her iki model de NVIDIA’nın yerel çıkarım motoru NeMo-Speech.cpp içinde, Jetson’un GPU’sunda çalışıyor.
Konuşmacı ayrımı hakkında daha fazla bilgi için NVIDIA’nın NeMo belgelerine göz atabilirsiniz.
Neler yapabilirsiniz?
Bir WAV, MP3, FLAC, OGG, Opus veya M4A dosyasını arayüze sürükleyip bıraktığınızda:
- Konuşmacıları ayırabilirsiniz. Her konuşmacı farklı bir renkle ve kendi zaman çizelgesinde gösterilir.
- Dökümü inceleyebilirsiniz. Zaman damgasına tıklayarak kaydın ilgili bölümünü doğrudan dinleyebilirsiniz.
- Kısa bir özet alabilirsiniz. Öne çıkan noktalar, kararlar ve yapılacak işler tek yerde toplanır.
- Kayıt hakkında soru sorabilirsiniz. Yanıtların dayandığı bölümlere zaman damgaları üzerinden ulaşabilirsiniz.
- Türkçe veya İngilizce kullanabilirsiniz. Arayüz, özetler ve yanıtlar seçtiğiniz dile göre çalışır.
- Sonucu Markdown olarak dışa aktarabilirsiniz. Döküm ve özet tek dosyada indirilebilir.
Nasıl çalışıyor?
Speech Studio, ses işleme ve metin tabanlı yapay zekâ özelliklerini aynı arayüzde bir araya getiriyor. Ses dosyası Jetson üzerinde işleniyor; konuşma tanıma, konuşmacı ayrımı, özetleme ve soru-cevap için dışarıya ses gönderilmiyor.
Kurulum sırasında gerekli modeller internetten indiriliyor. Kurulum tamamlandıktan sonra kayıtların işlenmesi cihaz üzerinde gerçekleşiyor. Web arayüzü varsayılan olarak yalnızca cihazdan erişilebiliyor; başka bir bilgisayardan bağlanmak için SSH tüneli kullanılabiliyor.
Deneme sonuçları ve sınırlar
Farklı kayıtlarla yapılan denemelerde sistem:
- 20 dakika 30 saniyelik bir kayıtta 3 konuşmacı ve 187 konuşma bölümü,
- 1 dakika 38 saniyelik yapay bir diyalogda 7 konuşmacı,
- yaklaşık 1 dakikalık üç kişilik podcast kesitlerinde 3 konuşmacı,
- Türkçe bir ses kaydında Türkçe döküm ve özet tespit etti.
Sonuçlar kullanılan modellere ve kaydın niteliğine göre değişebiliyor. Özetin kalitesi, özellikle küçük dil modellerinde, seçilen dile ve kaydın içeriğine bağlı. Canlı ses akışı modeller tarafından desteklense de mevcut arayüz şu anda yüklenmiş dosyalarla çalışıyor.
Kayıtlar cihazdaki library/ klasöründe saklanıyor. Bu klasördeki dosyaları silerek uygulamanın tuttuğu yerel kopyaları kaldırabilirsiniz.
Sonuç
Speech Studio, bir kaydı yazıya dökme, konuşmacılarını ayırma, özetleme ve kayıt içinde arama yapma işlerini tek bir arayüzde birleştiriyor. Bunu kendi donanımında yapmak isteyenler için Jetson Orin Nano, bu işlemleri yerel olarak çalıştırabilecek küçük ve pratik bir platform sunuyor.
Denemek, incelemek veya katkıda bulunmak için: github.com/openzeka/speech-studio
OPENZEKA HABERLERİ
Tavsiye Edilen Ürünler
OPENZEKA HABERLERİ
Hesaplarınızda paylaşmak ister misiniz?