
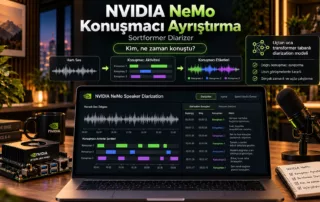
Kim, Ne Zaman Konuştu? NVIDIA Nemotron-3-Diarization ile Jetson Üzerinde Konuşmacı Ayrımı
Bir toplantıda, röportajda veya podcast’te belirli bir bölümü bulmak için kaydın tamamını dinlemek gerekebilir. “Kim, ne söyledi?” sorusunun yanıtı kayıtta olsa da ona ulaşmak zaman alır. Bulut tabanlı servisler bu işi kolaylaştırır; ancak bunun için ses kaydını başka bir sunucuya yüklemeniz gerekir. Speech Studio, bu işlemleri NVIDIA Jetson Orin ...(Devamını oku)
Tek Bir DGX Spark’ta BT Analiz Eden Tıbbi Yapay Zekâ ve 32B Model: MedPortal
Kontrastlı bir batın BT incelemesi yüzlerce kesit, onlarca organ ve gözden kaçmaması gereken çok sayıda olası bulgu demektir. Radyolojideki günlük zorluk tam da budur. Peki bu incelemeyi, hasta verisi kurum dışına hiç çıkmadan, masaüstündeki tek bir sistemde değerlendirmek mümkün olsaydı? OpenZeka'da geliştirdiğimiz MedPortal bu soruya yanıt veriyor. Tek bir ...(Devamını oku)
Qwen3.8-Flash-Next: Tek DGX Spark ve Tek RTX PRO 6000 ile Neler Mümkün?
Qwen3.8-Flash-Next, 262K token bağlam penceresine sahip, 176B parametreli bir Mixture-of-Experts modeli. Artificial Analysis Intelligence Index'te 39.8, Agentic Index'te 53.6 puana sahip.* NVIDIA NVFP4 checkpoint'i 132.7 GB. DGX Spark'ta 128 GB, RTX PRO 6000'de ise 96 GB bellek var; yani kâğıt üzerinde model ikisine de sığmıyor. Ölçümlerimizde ise ikisinde de ...(Devamını oku)
Dört DGX Spark Üzerinde DeepSeek-V4.1-Flash (763B) — 29.5 tok/s
DeepSeek-V4.1-Flash, 552 milyar parametrelik bir omurgaya sahip, çok modlu bir Mixture-of-Experts (MoE) modelidir. Hugging Face checkpoint'i 763 milyar parametre içerir: 552B omurga + 196B Engram koşullu bellek + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli. MXFP8 dense + MXFP4 expert ağırlık nicelemesi ve FP4 (E2M1) KV önbelleği ...(Devamını oku)