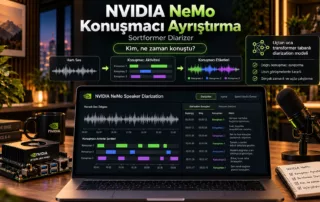
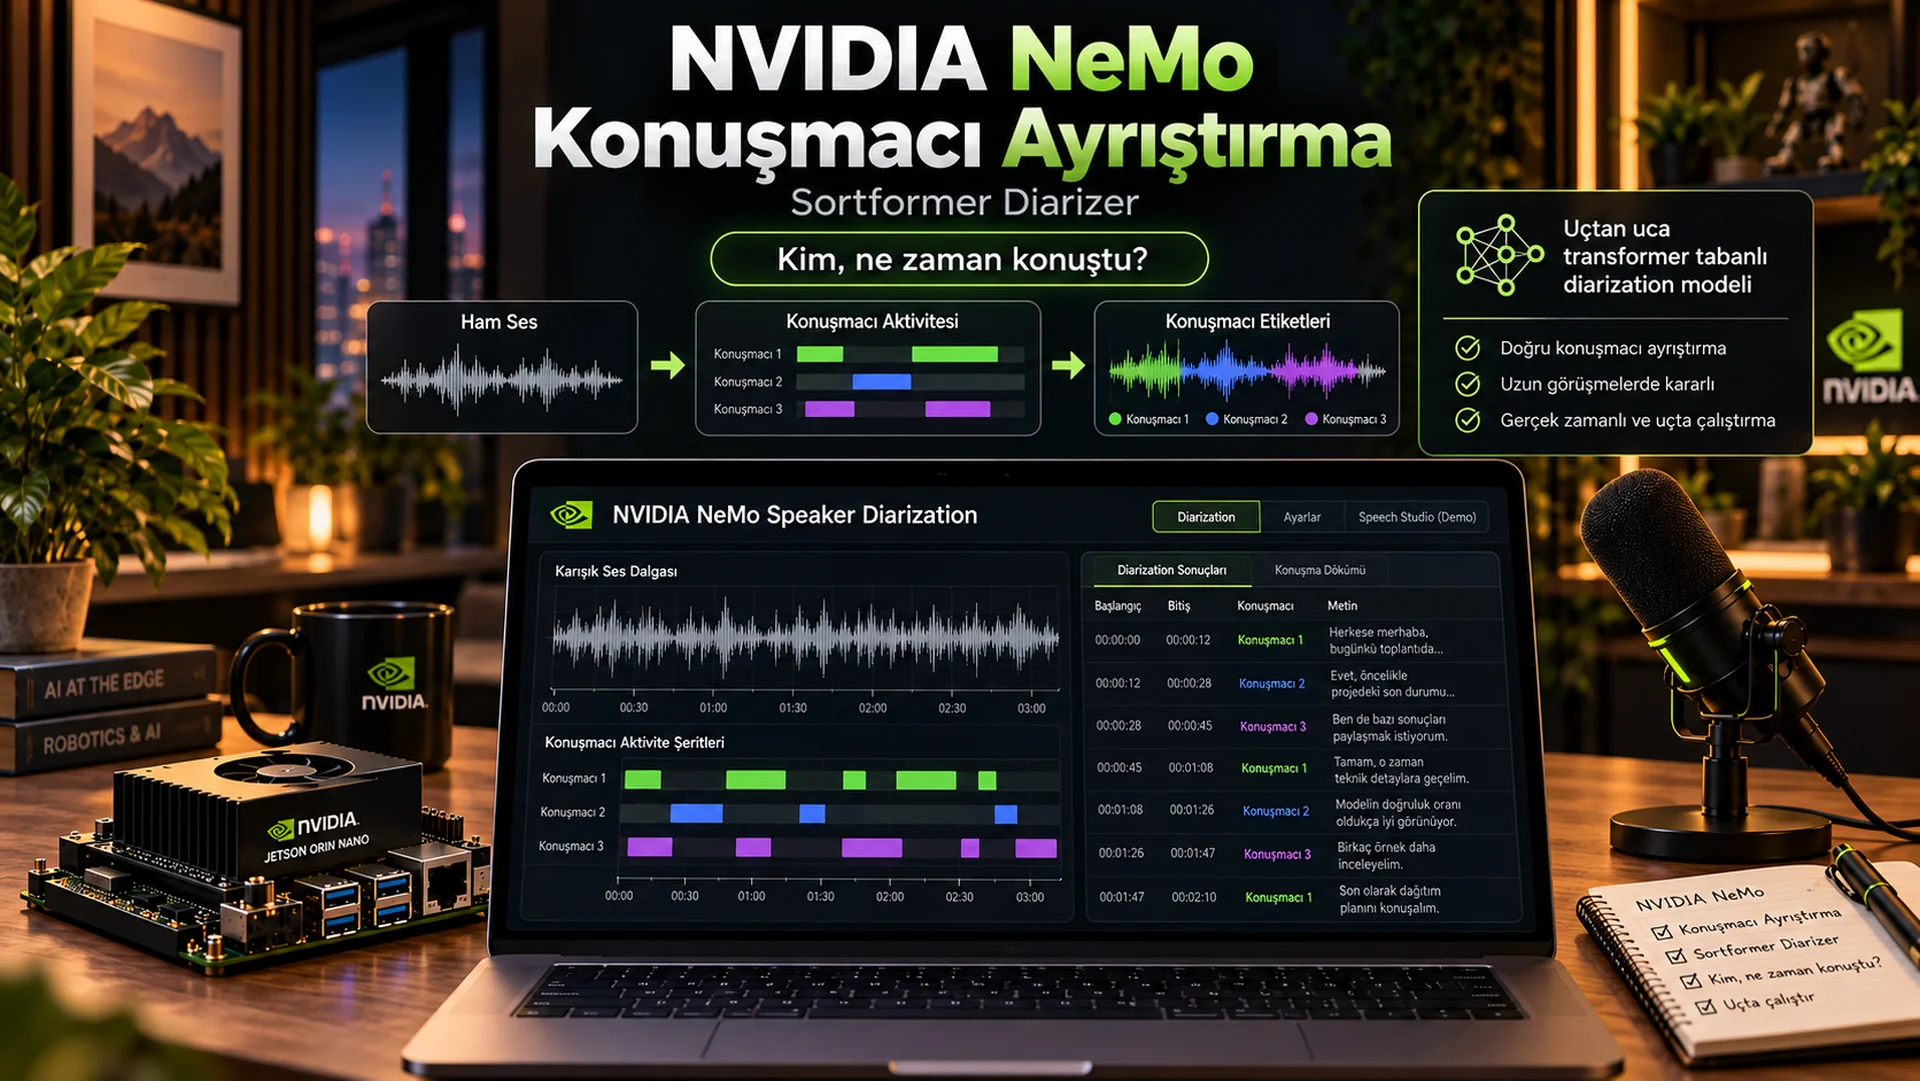
Kim, Ne Zaman Konuştu? NVIDIA Nemotron-3-Diarization ile Jetson Üzerinde Konuşmacı Ayrımı
Bir toplantıda, röportajda veya podcast’te belirli bir bölümü bulmak için kaydın tamamını dinlemek gerekebilir. “Kim, ne söyledi?” sorusunun yanıtı kayıtta olsa da ona ulaşmak zaman alır. Bulut tabanlı servisler bu işi kolaylaştırır; ancak bunun için ses kaydını başka bir sunucuya yüklemeniz gerekir. Speech Studio, bu işlemleri NVIDIA Jetson Orin ...(Devamını oku)
Tek Bir DGX Spark’ta BT Analiz Eden Tıbbi Yapay Zekâ ve 32B Model: MedPortal
Kontrastlı bir batın BT incelemesi yüzlerce kesit, onlarca organ ve gözden kaçmaması gereken çok sayıda olası bulgu demektir. Radyolojideki günlük zorluk tam da budur. Peki bu incelemeyi, hasta verisi kurum dışına hiç çıkmadan, masaüstündeki tek bir sistemde değerlendirmek mümkün olsaydı? OpenZeka'da geliştirdiğimiz MedPortal bu soruya yanıt veriyor. Tek bir ...(Devamını oku)
Qwen3.8-Flash-Next: Tek DGX Spark ve Tek RTX PRO 6000 ile Neler Mümkün?
Qwen3.8-Flash-Next, 262K token bağlam penceresine sahip, 176B parametreli bir Mixture-of-Experts modeli. Artificial Analysis Intelligence Index'te 39.8, Agentic Index'te 53.6 puana sahip.* NVIDIA NVFP4 checkpoint'i 132.7 GB. DGX Spark'ta 128 GB, RTX PRO 6000'de ise 96 GB bellek var; yani kâğıt üzerinde model ikisine de sığmıyor. Ölçümlerimizde ise ikisinde de ...(Devamını oku)
Dört DGX Spark Üzerinde DeepSeek-V4.1-Flash (763B) — 29.5 tok/s
DeepSeek-V4.1-Flash, 552 milyar parametrelik bir omurgaya sahip, çok modlu bir Mixture-of-Experts (MoE) modelidir. Hugging Face checkpoint'i 763 milyar parametre içerir: 552B omurga + 196B Engram koşullu bellek + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli. MXFP8 dense + MXFP4 expert ağırlık nicelemesi ve FP4 (E2M1) KV önbelleği ...(Devamını oku)
NVIDIA Cosmos 3: Robotlar için Tek Modelde Akıl Yürütme, Dünya Simülasyonu ve Eylem
Bir robotun akşam yemeğinden sonra masayı toplaması için bugüne kadar üç ayrı model gerekiyordu. Sahneyi anlayıp plan çıkaran bir görsel-dil modeli (VLM), o planı motor komutlarına çeviren bir eylem modeli (VLA) ve “Bu hareketi yaparsam ne olur?” sorusunu yanıtlayan bir dünya modeli. Üç model demek, üç ayrı çıkarım servisi, ...(Devamını oku)
DGX Spark Üzerinde Qwen3.8-27B — 48 tok/s
Qwen3.8-27B, Alibaba tarafından Ağustos 2026'da yayımlanan 27 milyar parametreli bir dil modelidir. Artificial Analysis Intelligence Index'te 52 puan alarak, kendi sınıfında (40B altı açık ağırlıklı modeller) 1. sıraya yerleşmiştir. Bu eğitimde, tek bir DGX Spark üzerinde Qwen3.8-27B-NVFP4'ü, SGLang çıkarım motoru ve DFlash2 draft modeli (spekülatif kod çözme) ile çalıştıracak ...(Devamını oku)
DGX Spark Üzerinde sparkrun ile Yerel GPT-OSS 120B Sunumu
Bu eğitimde, tek veya birden çok DGX Spark üzerinde bir büyük dil modelini sparkrun kullanarak çalıştıracaksınız. Spark, monitör ve klavye bağlayarak doğrudan bilgisayar olarak kullanılabileceği gibi, başka bir bilgisayarla uzaktan bağlanılan bir sunucu olarak da kullanılabilir. Biz bu eğitimde Spark’a uzaktan bağlanacağız ve gerekli yazılımları kurup modeli çalıştıracağız. Dil ...(Devamını oku)
NVIDIA Jetson Orin Nano 2 Duyuruldu: Kompakt Yapıda 78 TOPS Yapay Zeka Performansı
NVIDIA, giriş seviyesi Edge AI sistemlerinde performans çıtasını yükselten yeni Jetson Orin Nano 2 platformunu duyurdu. Geliştirilmiş Tensor çekirdekleri ve artırılmış bellek bant genişliğiyle gelen yeni nesil üretken yapay zekâ süper bilgisayarı; Jetson Orin Nano Super’a kıyasla iki kata kadar daha yüksek çıkarım performansı sunuyor. Jetson Orin Nano 2, ...(Devamını oku)
NVIDIA DGX Spark Ekosistemi
Kaynaklar, Araçlar ve Topluluk NVIDIA DGX Spark™, yapay zeka modelleriyle çalışmak isteyenler için tasarlanmış kompakt bir masaüstü AI sistemidir. Geliştirme, test, çıkarım, ince ayar ve prototipleme süreçlerini tek bir platformda toplar. Cihaz etrafında oluşan yazılım ve bilgi ekosistemi oldukça güçlüdür: modeller, Docker imajları, NVIDIA playbook'lar ...(Devamını oku)
Jetson & Spark Performans Rehberi: Modeller Hangi Metriklerde Nasıl Performans Gösteriyor?
Edge cihazda büyük dil modeli çalıştırmak, artık "çalışır mı?" sorusundan çok "ne kadar akıcı çalışır?" sorusuna evrildi. Bu yazıda, Jetson cihaz ailesinde hangi modellerin çalıştığını, hangi nicemleme ve runtime kombinasyonunun ne kadar hız verdiğini, ve en önemlisi — farklı hızların ekranda nasıl hissettirdiğini ele alacağız. Hız Nasıl Hissedilir? ...(Devamını oku)
Kim, Ne Zaman Konuştu? NVIDIA Nemotron-3-Diarization ile Jetson Üzerinde Konuşmacı Ayrımı
Bir toplantıda, röportajda veya podcast’te belirli bir bölümü bulmak için kaydın tamamını dinlemek gerekebilir. “Kim, ne söyledi?” sorusunun yanıtı kayıtta olsa da ona ulaşmak zaman alır. Bulut tabanlı servisler ...(Devamını oku)
Tek Bir DGX Spark’ta BT Analiz Eden Tıbbi Yapay Zekâ ve 32B Model: MedPortal
Kontrastlı bir batın BT incelemesi yüzlerce kesit, onlarca organ ve gözden kaçmaması gereken çok sayıda olası bulgu demektir. Radyolojideki günlük zorluk tam da budur. Peki bu incelemeyi, hasta verisi ...(Devamını oku)
Qwen3.8-Flash-Next: Tek DGX Spark ve Tek RTX PRO 6000 ile Neler Mümkün?
Qwen3.8-Flash-Next, 262K token bağlam penceresine sahip, 176B parametreli bir Mixture-of-Experts modeli. Artificial Analysis Intelligence Index'te 39.8, Agentic Index'te 53.6 puana sahip.* NVIDIA NVFP4 checkpoint'i 132.7 GB. DGX Spark'ta 128 ...(Devamını oku)
Dört DGX Spark Üzerinde DeepSeek-V4.1-Flash (763B) — 29.5 tok/s
DeepSeek-V4.1-Flash, 552 milyar parametrelik bir omurgaya sahip, çok modlu bir Mixture-of-Experts (MoE) modelidir. Hugging Face checkpoint'i 763 milyar parametre içerir: 552B omurga + 196B Engram koşullu bellek + ~15B ...(Devamını oku)
NVIDIA Cosmos 3: Robotlar için Tek Modelde Akıl Yürütme, Dünya Simülasyonu ve Eylem
Bir robotun akşam yemeğinden sonra masayı toplaması için bugüne kadar üç ayrı model gerekiyordu. Sahneyi anlayıp plan çıkaran bir görsel-dil modeli (VLM), o planı motor komutlarına çeviren bir eylem ...(Devamını oku)
DGX Spark Üzerinde Qwen3.8-27B — 48 tok/s
Qwen3.8-27B, Alibaba tarafından Ağustos 2026'da yayımlanan 27 milyar parametreli bir dil modelidir. Artificial Analysis Intelligence Index'te 52 puan alarak, kendi sınıfında (40B altı açık ağırlıklı modeller) 1. sıraya yerleşmiştir. ...(Devamını oku)
DGX Spark Üzerinde sparkrun ile Yerel GPT-OSS 120B Sunumu
Bu eğitimde, tek veya birden çok DGX Spark üzerinde bir büyük dil modelini sparkrun kullanarak çalıştıracaksınız. Spark, monitör ve klavye bağlayarak doğrudan bilgisayar olarak kullanılabileceği gibi, başka bir bilgisayarla ...(Devamını oku)
NVIDIA Jetson Orin Nano 2 Duyuruldu: Kompakt Yapıda 78 TOPS Yapay Zeka Performansı
NVIDIA, giriş seviyesi Edge AI sistemlerinde performans çıtasını yükselten yeni Jetson Orin Nano 2 platformunu duyurdu. Geliştirilmiş Tensor çekirdekleri ve artırılmış bellek bant genişliğiyle gelen yeni nesil üretken yapay ...(Devamını oku)
NVIDIA DGX Spark Ekosistemi
Kaynaklar, Araçlar ve Topluluk NVIDIA DGX Spark™, yapay zeka modelleriyle çalışmak isteyenler için tasarlanmış kompakt bir masaüstü AI sistemidir. Geliştirme, test, çıkarım, ince ayar ve prototipleme süreçlerini tek ...(Devamını oku)
Jetson & Spark Performans Rehberi: Modeller Hangi Metriklerde Nasıl Performans Gösteriyor?
Edge cihazda büyük dil modeli çalıştırmak, artık "çalışır mı?" sorusundan çok "ne kadar akıcı çalışır?" sorusuna evrildi. Bu yazıda, Jetson cihaz ailesinde hangi modellerin çalıştığını, hangi nicemleme ve runtime ...(Devamını oku)

GTC 2022: Hopper, Omniverse, Gömülü Sistemler ve Dahası
NVIDIA GTC 2022'de Jensen Huang, yeni silikonlar olarak geçen, Hopper GPU mimarisi, H100 GPU, yenilenmiş AI ve hızlandırılmış hesaplama yazılımları ve veri merkezi sistemlerini ...(Devamını oku)
SIGGRAPH Yine Dopdolu
NVIDIA'nın grafik konusunda yaptığı akademik iş birlikleriyle yeni araştırma makaleleri yayınlandı. Bunlardan birkaçı: kılıç savurma, geri çekilme gibi atletik hareketleri yumuşak geçişler ile simüle ...(Devamını oku)
NVIDIA DGX Spark Ekosistemi
Kaynaklar, Araçlar ve Topluluk NVIDIA DGX Spark™, yapay zeka modelleriyle çalışmak isteyenler için tasarlanmış kompakt bir masaüstü AI sistemidir. Geliştirme, test, çıkarım, ince ...(Devamını oku)
DGX Spark Recovery
Sistem Kurtarmaya Genel Bakış DGX Spark sistem kurtarma işlemi, işletim sistemi ve firmware’i fabrika çıkışındaki durumuna geri döndürmenizi sağlar. Sistem dosyalarının bozulması, ciddi yapılandırma ...(Devamını oku)

Bir Startup’ın Herbisitlere Yönelik Geliştirdiği Ot Tanıma, Çiftçiler İçin Verimi Artırıyor
Guillaume Jourdain, Hugo Serrat ve Jules Beguerie, yapay zekayı tarıma uygulamak için 2014 yılında bir startup kurmayı düşündüklerinde bundan pek emin değillerdi. Bu tür AI ...(Devamını oku)
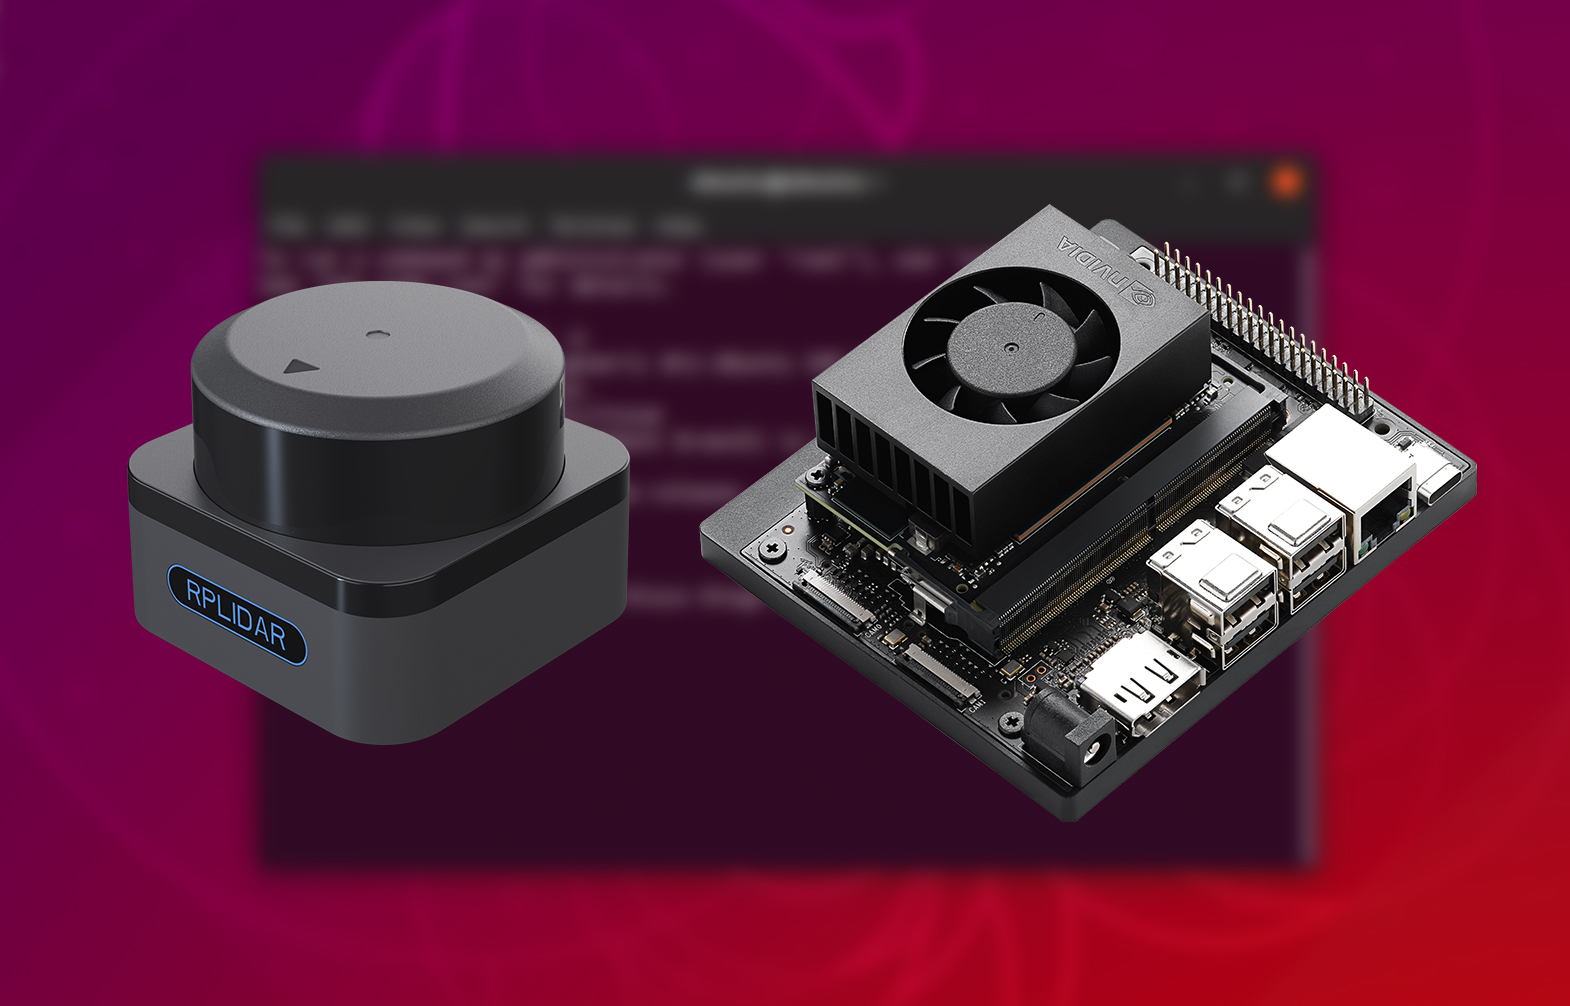
RPLidar Jetson Kurulumu
Bu yazıda haritalama, konumlandırma ve yönlendirme projelerinde sıklıkla kullanılan RPLidar modellerinin kurulumunu anlatacağız. Neler Gerekli? Jetson Hazır Yapay Zeka Kiti Projenize uygun RPLidar 1- ...(Devamını oku)