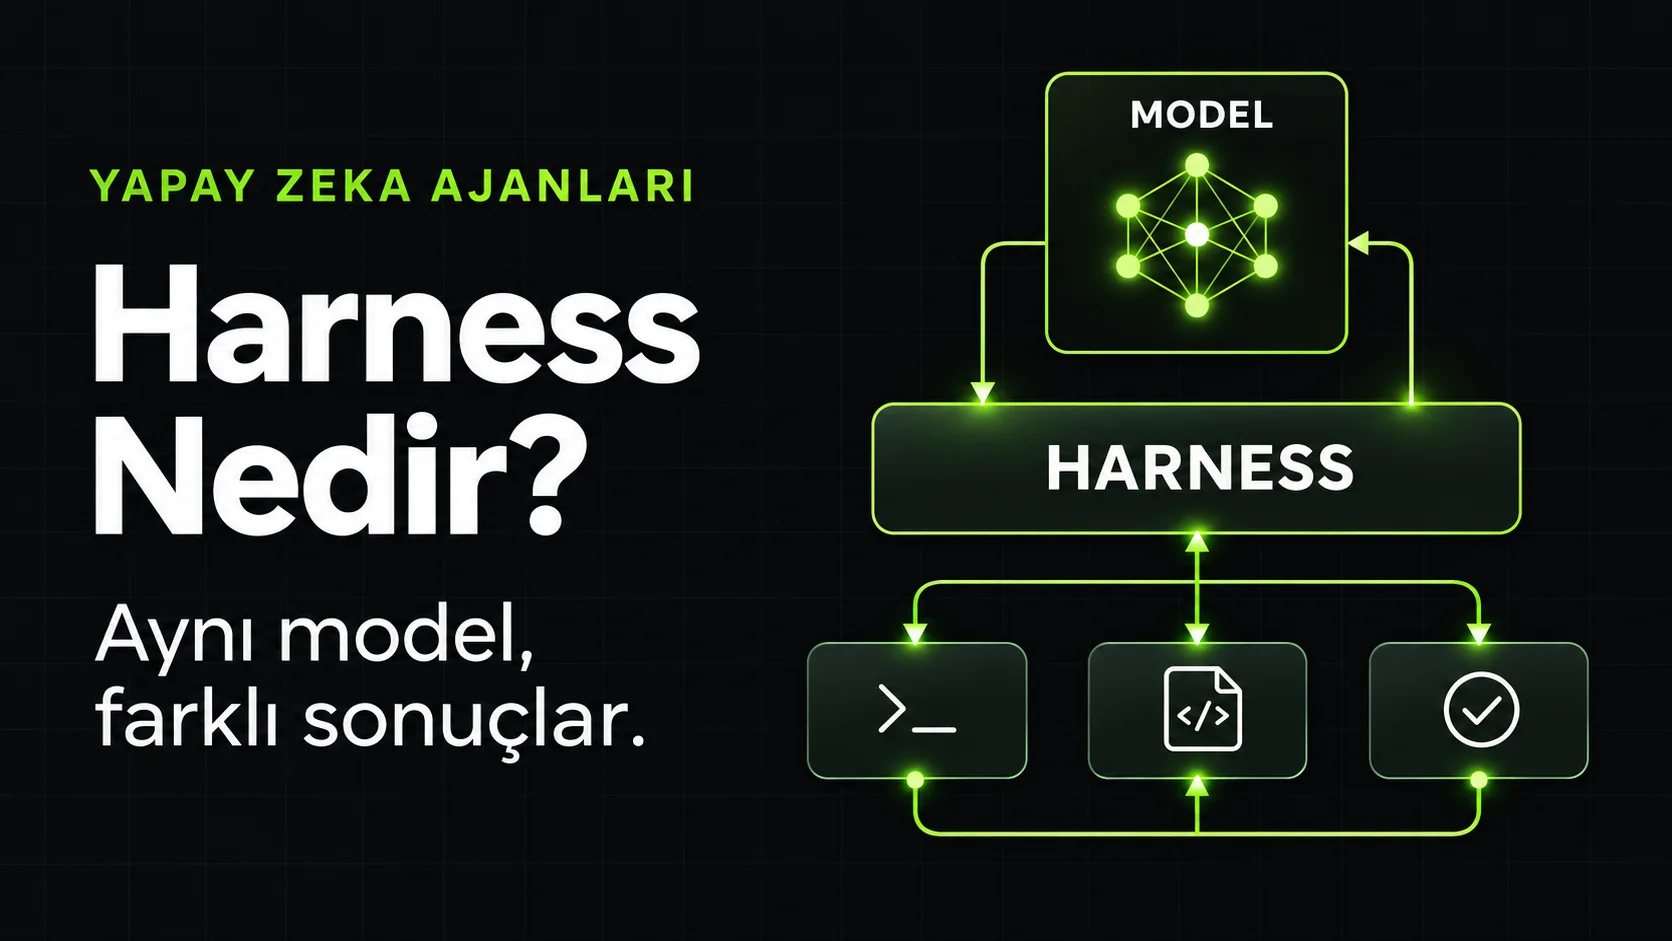
Bir yapay zeka modeline kod yazdırmakla, bir projedeki hatayı bulup düzeltmesini sağlamak arasında çok sayıda işlem var: Dosyaları incelemek, komut çalıştırmak, kodu değiştirmek, test sonuçlarını okumak ve gerekirse yeniden denemek. Harness, modelin bu işlemleri yürütmesini sağlayan yazılım katmanıdır.
Joël Niklaus’un Harness Leaderboard çalışması, aynı modelleri farklı harness’larla çalıştırarak bu katmanın etkisini ölçüyor. İncelenen sonuçlarda en yüksek ve en düşük makro başarı oranları arasında yaklaşık 24 yüzde puan bulunuyor.
Harness Modelin Çalışma Biçimini Nasıl Değiştiriyor?
Model, hangi işlemi yapacağını seçer; harness bu işlemi çalıştırır ve sonucu modele geri verir. Bir hata düzeltme görevinde döngü şöyle ilerleyebilir:
Dosyayı incele → Değişiklik yap → Testi çalıştır → Hatayı değerlendir → Düzeltmeyi güncelle
Harness’lar bu döngünün üç önemli noktasında ayrışır:
Araçların sunumu: Bir harness modele yalnızca bash sunarken, diğeri dosya okuma, arama ve düzenleme için ayrı araçlar tanımlayabilir. İlkinde model birçok işlemi terminal komutlarıyla çözer; ikincisinde işlem için uygun aracı ve parametreleri seçer.
Bağlam yönetimi: Uzun görevlerde dosyalar, araç çıktıları ve konuşma geçmişi birikir. Hangi bilginin tutulduğu, hangisinin özetlendiği ve hata çıktılarının nasıl aktarıldığı sonraki kararları etkiler.
Görevlerin bölünmesi: Bazı harness’lar işi tek bir ajan döngüsünde yürütürken bazıları alt ajanlara ayırabilir. Ayrı bağlamlarda çalışan ajanların bulgularının ana göreve aktarılması da bu tasarımın parçasıdır. Harness’ların bu üç noktadaki tercihleri, Harness Lens mimari karşılaştırmasında yan yana incelenebilir.
Harness Leaderboard Neyi Ölçüyor?
Çalışma; GLM-5.3-Flash, DeepSeek-V4.1-Flash ve Flint modellerini dokuz harness ile değerlendiriyor. Karşılaştırmalarda model, sağlayıcı ve akıl yürütme seviyesi sabit tutuluyor; her görev üç kez deneniyor. Terminal-Bench 2.1 terminal görevlerini, DeepSWE v1.1 ise gerçek kod depolarındaki geliştirme görevlerini kapsıyor.
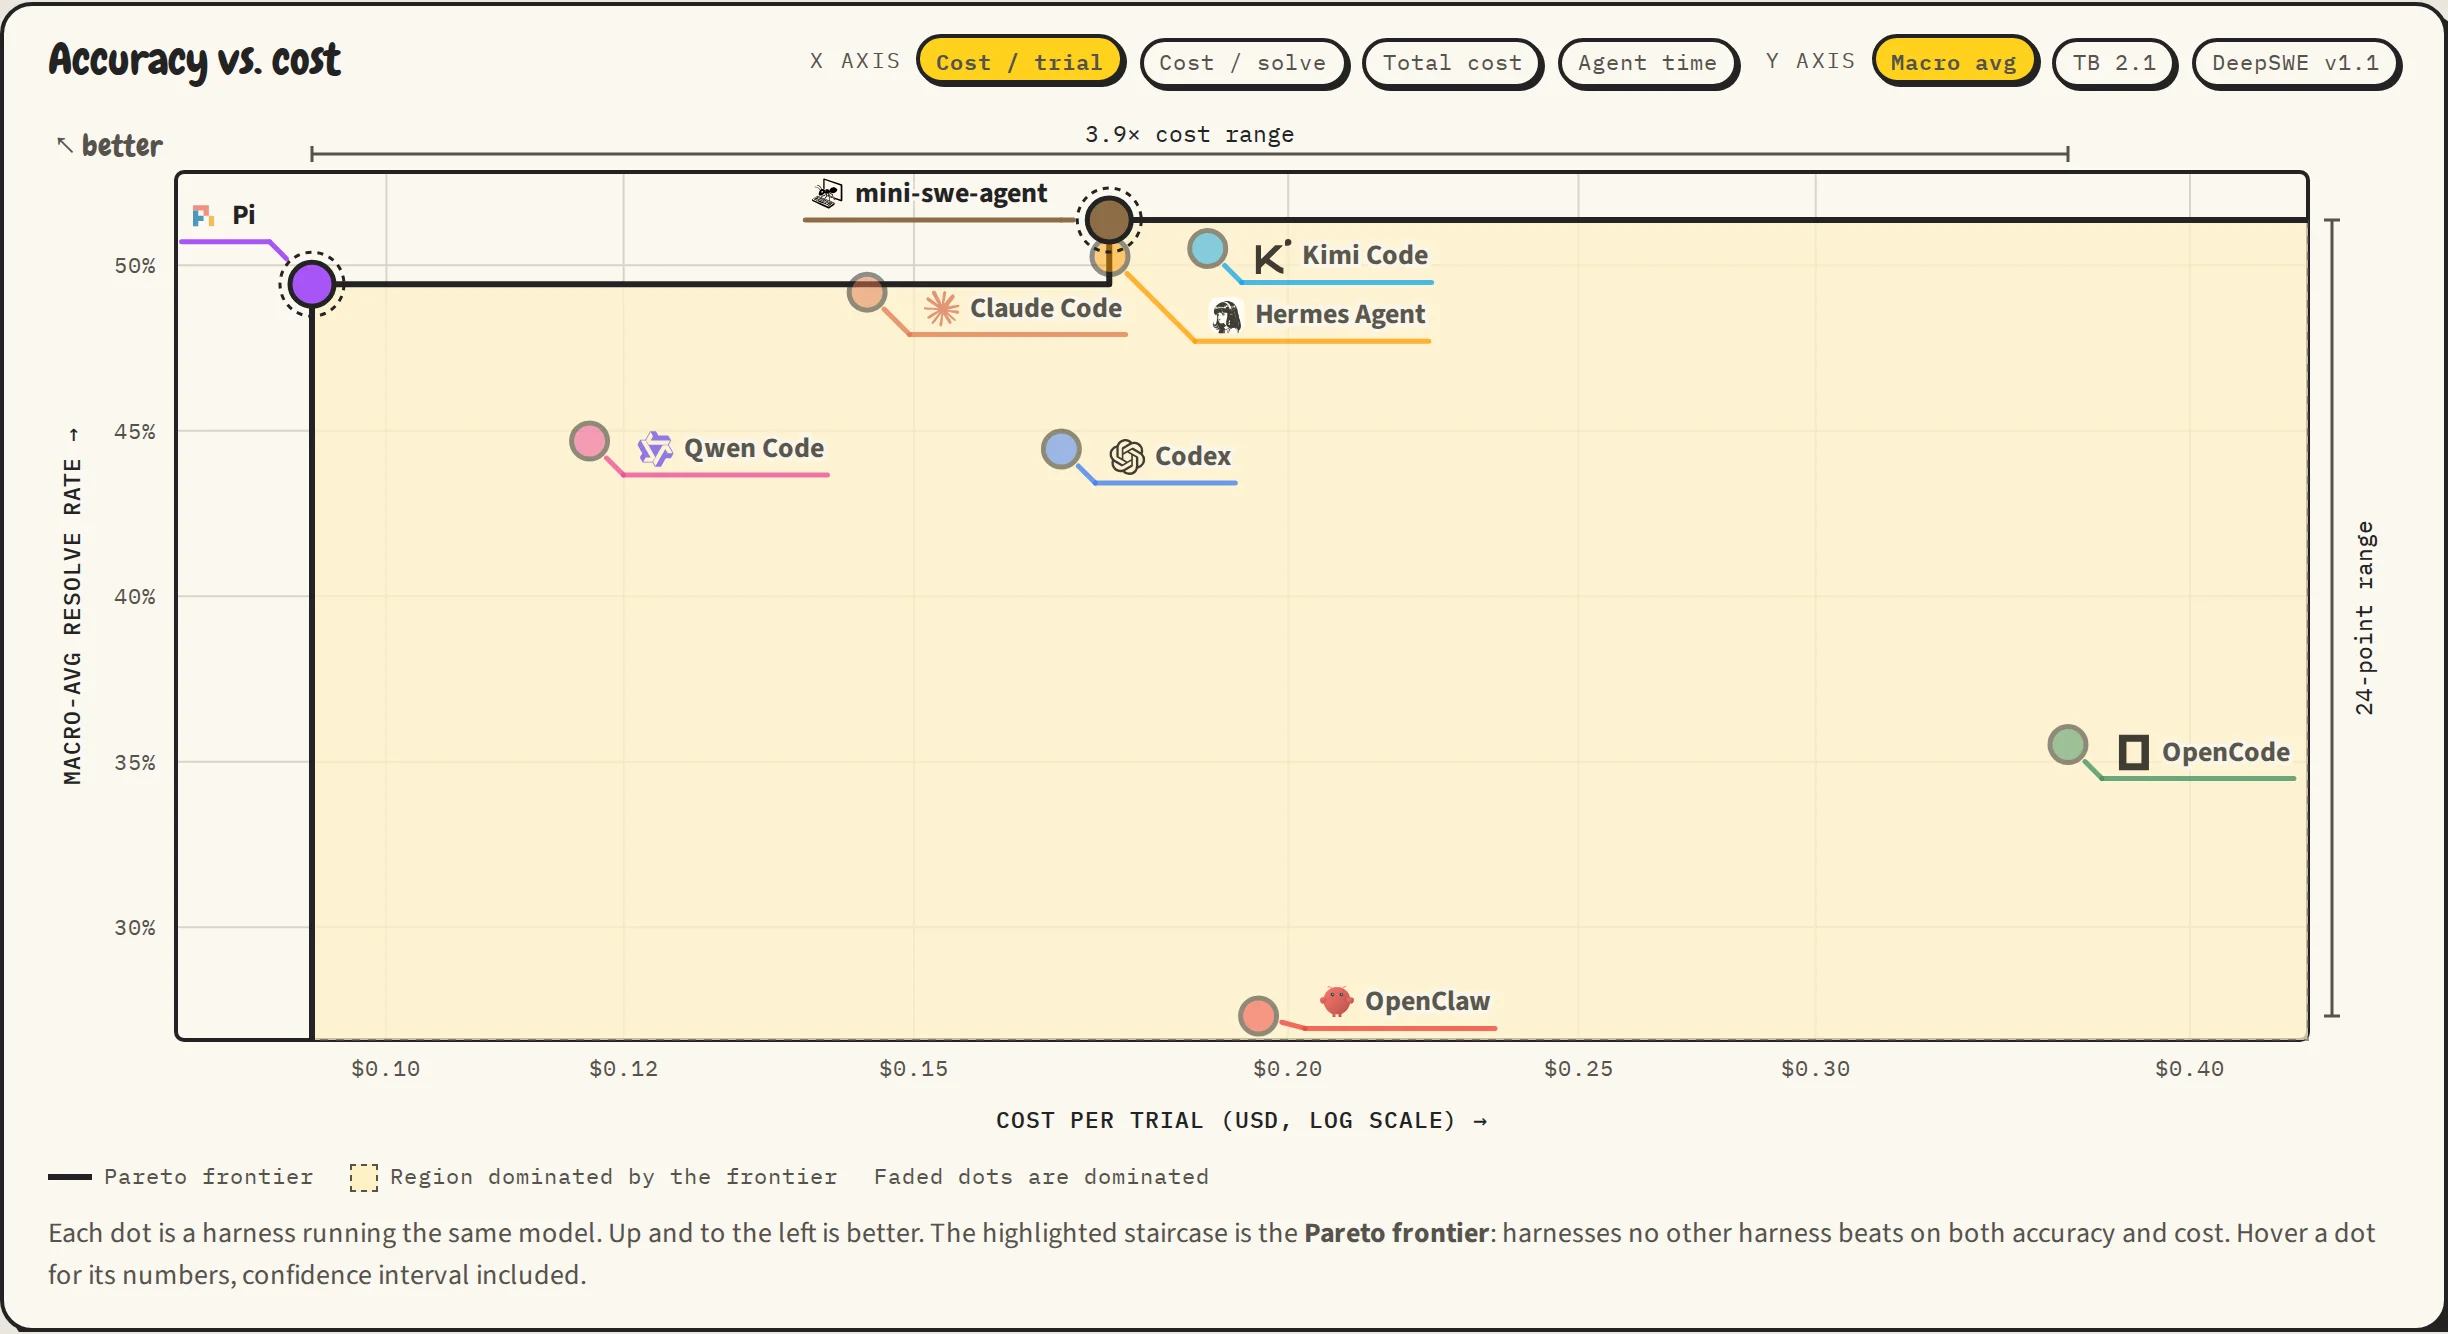
Kaynak sayfadaki orijinal başarı–maliyet grafiği. Tam boyut için görsele tıklayın.
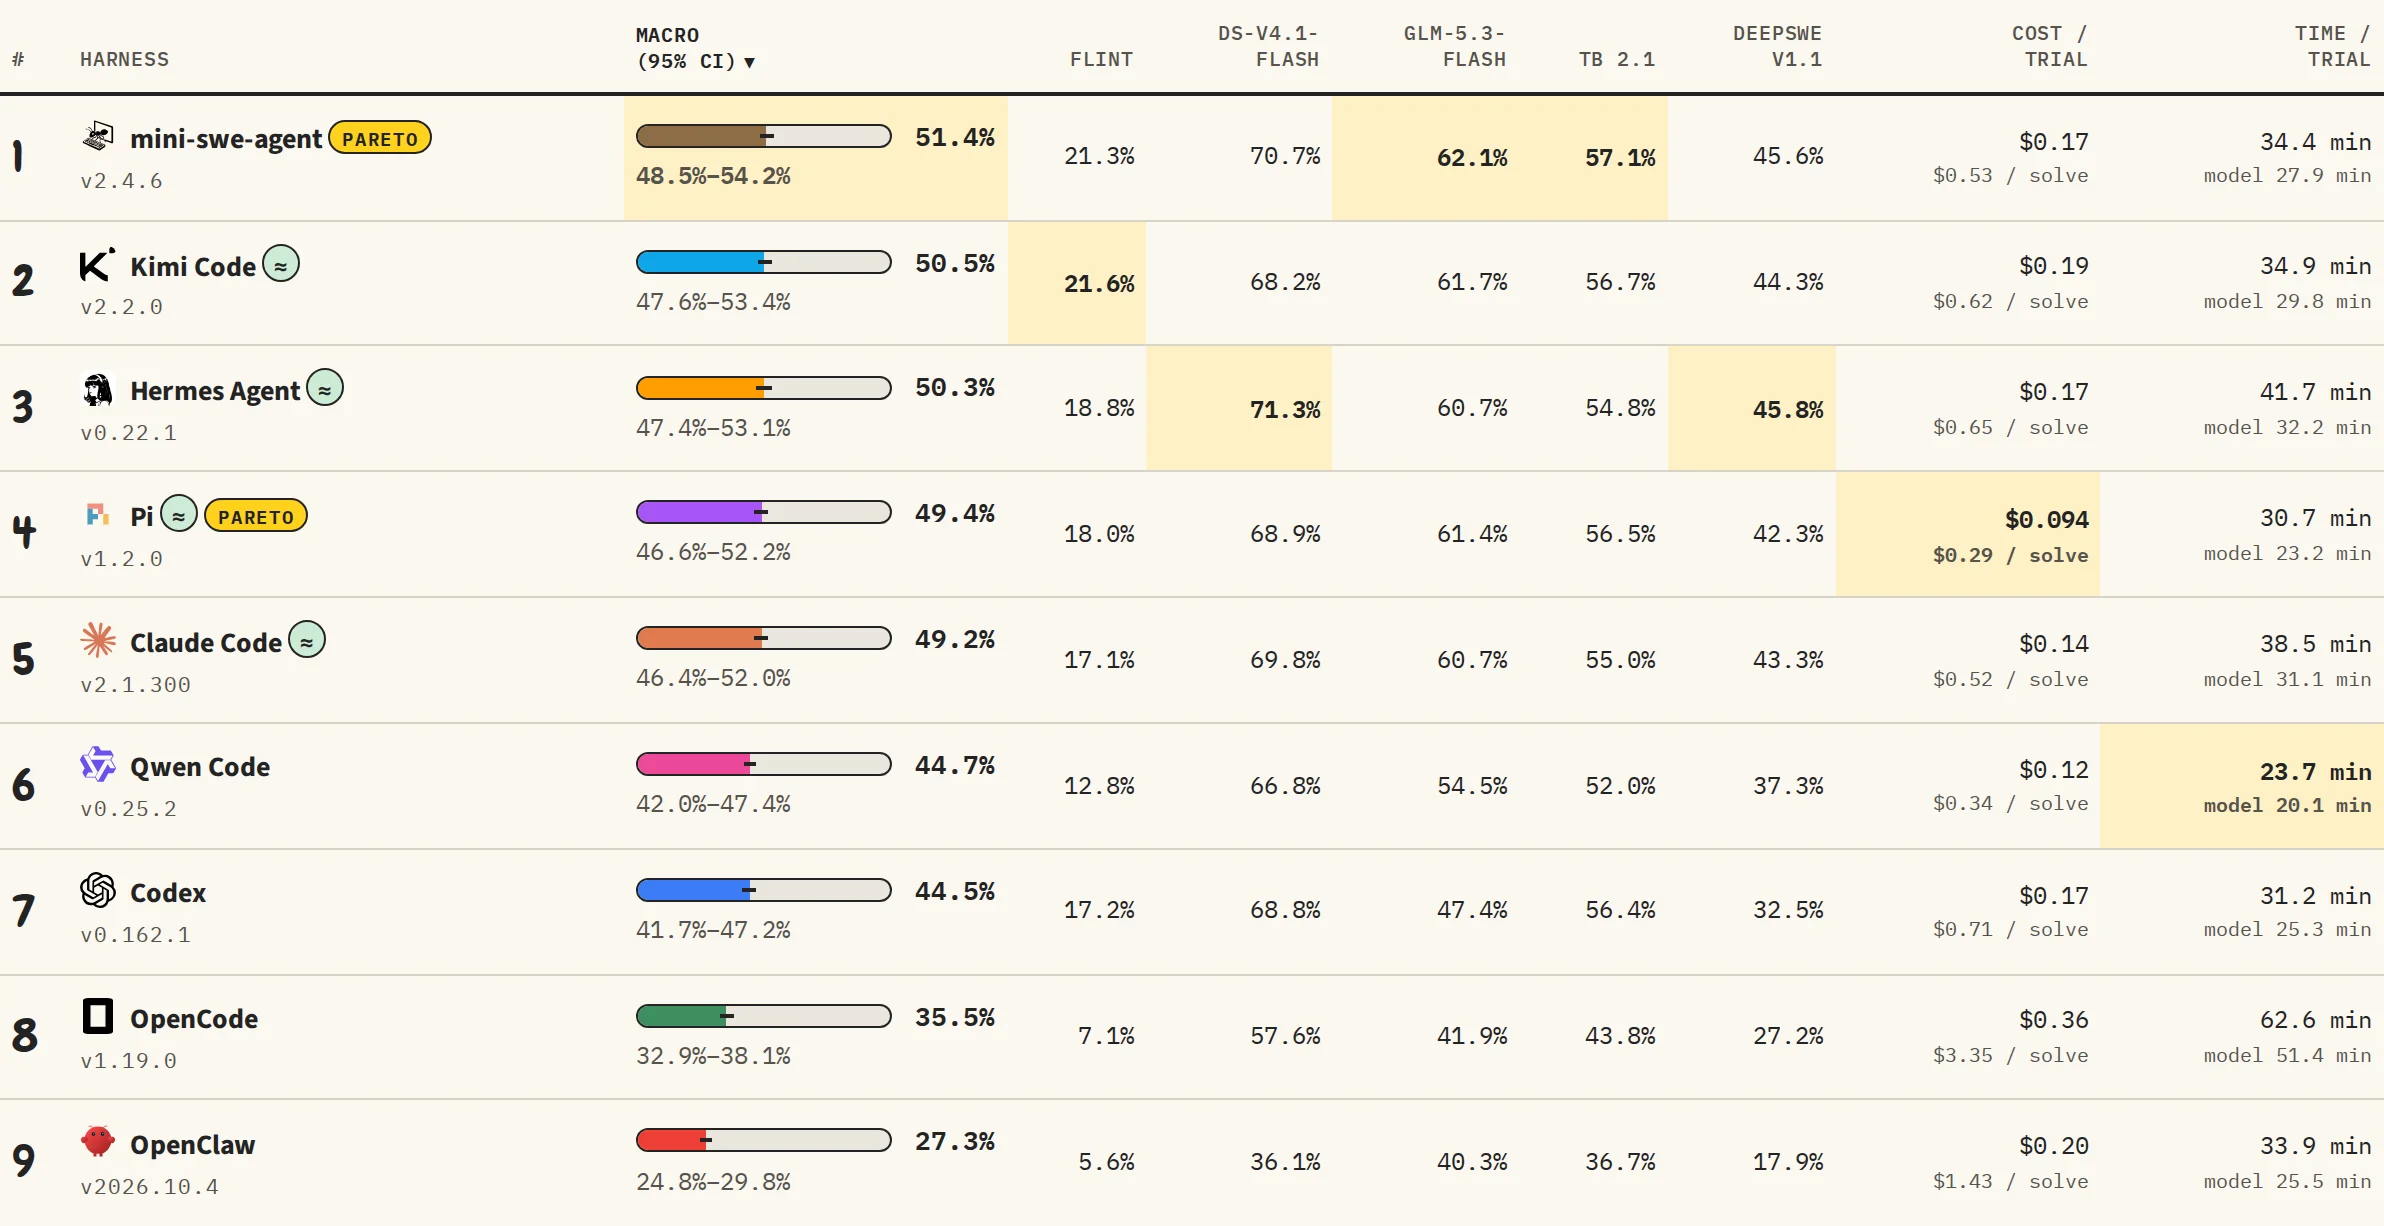
Orijinal sonuç tablosu. Kaynak: Joël Niklaus / Hugging Face, v0.1.1; 6 Kasım 2026.
Benchmark Sonuçları Bize Ne Anlatıyor?
Genel ortalamada mini-swe-agent önde, ancak zirvedeki farklar küçük. mini-swe-agent %51,4; Kimi Code %50,5; Hermes Agent %50,3; Pi %49,4 ve Claude Code %49,2 makro başarıya ulaşıyor. Bu puan, denemelerdeki başarıların görevler, benchmark’lar ve modeller üzerinden ortalanmasıyla hesaplanıyor. “Üç denemeden en az birinde çözülen görevlerin oranı” ile aynı ölçüm değil. Çalışmanın istatistiksel karşılaştırmasında bu dört harness’ın liderden anlamlı biçimde ayrışmaması, tek başına birinci sıraya bakarak seçim yapmanın yeterli olmadığını gösteriyor.
Listenin iki ucu arasında belirgin bir fark var. OpenClaw’ın %27,3 sonucu ile mini-swe-agent arasında 24,1 yüzde puan bulunuyor. Bu fark, aynı modellerle yapılan karşılaştırmada harness seçiminin sonucu değiştirebildiğini gösteriyor; hangi tasarım özelliğinin ne kadar katkı yaptığını ise tek başına açıklamıyor.
Model değiştiğinde en yüksek puanı alan harness da değişiyor. Model bazındaki ortalamalarda tablo şöyle:
| Model | En yüksek başarıyı alan harness | Başarı oranı |
|---|---|---|
| GLM-5.3-Flash | mini-swe-agent | %62,1 |
| DeepSeek-V4.1-Flash | Hermes Agent | %71,3 |
| Flint | Kimi Code | %21,6 |
Bu nedenle genel sıralama, kullanacağınız model için doğrudan bir tercih listesi sayılmamalı. Örneğin genel ortalamada üçüncü olan Hermes Agent, DeepSeek-V4.1-Flash ile en yüksek puanı alıyor. Buradaki sıra da farkların istatistiksel olarak anlamlı olduğunu tek başına göstermiyor.
Yakın başarı, farklı maliyetlerle elde edilebiliyor. Pi’nin başarılı deneme başına maliyeti 0,29 dolar; mini-swe-agent’ınki 0,53 dolar. Pi, bu ölçümde yaklaşık %45 daha düşük maliyetle yakın bir başarı düzeyine ulaşıyor. Grafikte yukarı doğru çıkmak başarı oranının artmasını, sola ilerlemek ise deneme başına maliyetin düşmesini gösteriyor. Dolayısıyla değerlendirme, başarı ve maliyeti birlikte ele almalı. Bu rakamlar çalışmanın model çıkarım maliyetlerini yansıtıyor; yerel donanımın toplam işletim maliyeti değil.
Tüm sonuçlar, 6 Kasım 2026’da incelenen v0.1.1 sürümüne ve belirtilen test koşullarına aittir; puanların nasıl hesaplandığı, benchmark sonuçları ve hesaplama yöntemiyle birlikte kaynak sayfada açıklanıyor.
Harness’lar Arasında Hangi Farklar Öne Çıkıyor?
mini-swe-agent: Bash Üzerinden Sade Bir Döngü
mini-swe-agent’ın yaklaşımı, modele bash üzerinden işlem yaptırmak ve sonuçları mesaj geçmişine eklemek. Dosya inceleme, arama ve test çalıştırma gibi işler aynı arayüzle yürütülüyor. Ayrı araçlar arasında seçim yapmak yerine model, terminali kullanarak ilerliyor.
Bu yapı, ajanın hangi komutu çalıştırdığını ve hangi çıktıyı gördüğünü izlemeyi kolaylaştırıyor. Model, ortam ve ajan bileşenlerinin değiştirilebilmesi de farklı kurulumları karşılaştırmak isteyen ekipler için yararlı; bu bileşenlerin nasıl yapılandırıldığı mini-swe-agent dokümantasyonunda anlatılıyor.
Pi: Küçük Çekirdek, Genişletilebilir Yapı
Pi’nin temel araçları dosya okuma, yazma, düzenleme ve bash çalıştırma etrafında toplanıyor. Böylece dosya işlemleri için ayrı araçlar sunarken çekirdeği küçük tutuyor. Ek davranışlar eklentilerle kazandırılabiliyor; alt ajan kullanımı da eklenti üzerinden kurulabiliyor.
Leaderboard’da Pi, %49,4 makro başarı ve başarılı deneme başına 0,29 dolar ile dikkat çekiyor. mini-swe-agent için aynı maliyet 0,53 dolar. Bu sonuç, birbirine yakın başarı düzeylerinde kaynak tüketiminin farklılaşabildiğini gösteriyor. Eklenti tabanlı yapı Pi mimarisi sayfasında, deneme başına maliyetler ise leaderboard’un maliyet sonuçlarında görülebilir.
Kimi Code ve Hermes Agent: İşi Bölmek ve Bağlamı Düzenlemek
Kimi Code, kodlama, keşif ve planlama gibi rollerle alt ajanlar kullanabiliyor. Hermes Agent da alt görevleri ayrı bağlamlarda çalıştırabiliyor; ayrıca kalıcı notlar ve kullanıcı profili gibi bellek özellikleri sunuyor.
Bu özellikler farklı ihtiyaçlara karşılık geliyor: Bir kod deposunu incelemeyi ayrı bir ajana vermek, ana çalışma bağlamını daha sınırlı tutabilir. Oturumlar arasında not saklamak ise tekrarlanan işlerde önceki bilgilerin kullanılmasını sağlayabilir. Ancak bu özelliklerin tek tek ne kadar başarı kazandırdığı, leaderboard’daki toplam puandan çıkarılamaz. Alt ajan ve bellek yeteneklerinin kapsamı, Kimi Code ve Hermes Agent için Harness Lens’teki sayfalarda özetleniyor.
Claude Code, Codex ve Qwen Code: Proje İçinde Çalışan Ajanlar
Bu araçlar dosya değişikliklerini, komut çalıştırmayı ve proje talimatlarını ajan akışına dahil ediyor. Farkları, modele sunulan araçların yanında proje bilgisinin nasıl yüklendiğinde de görülüyor: Claude Code, CLAUDE.md; Codex, AGENTS.md; Qwen Code ise QWEN.md ve AGENTS.md gibi dosyalardan yararlanabiliyor.
Bu talimatlar, test komutları veya projenin geliştirme kuralları gibi bilgileri ajana aktarmak için kullanılabiliyor. Aynı görev ve modelde bile farklı talimat yükleme ve araç tasarımları, modelin önüne farklı bir çalışma bağlamı koyabiliyor. Araçların hangi talimat dosyalarını okuduğu ve hangi araçları sunduğu, proje talimatları ve araç karşılaştırması tablosunda listeleniyor.
OpenCode ve OpenClaw: Farklı Kapsamlardaki İki Yaklaşım
OpenCode, farklı model sağlayıcılarına bağlanabilen, kodlama araçları ve eklentilerle genişletilebilen bir geliştirme ortamı sunuyor. OpenClaw’ın kapsamı ise kodlamanın yanında iletişim kanallarını, oturumları ve aranabilir belleği de içeriyor.
Bu ayrım sonuçları yorumlarken önemli: Otonom kodlama benchmark’ı, daha geniş bir ajan ortamının bütün yeteneklerini ölçmüyor. Kullanılacak araç seçilirken yazılım geliştirme başarısının yanında hangi uygulamalara ve çalışma kanallarına bağlanacağı da dikkate alınmalı. OpenCode ve OpenClaw sayfalarındaki yetenek listeleri, bu kapsam farkını değerlendirirken başlangıç noktası olabilir.
Yerel LLM’de Harness Kadar Donanım da Belirleyici
Bir ajan görevi boyunca modele tekrar tekrar başvurur. Her çağrının gecikmesi toplam çalışma süresine eklenir; uzun kod dosyaları ve araç çıktıları da bağlamı büyütür. Model yerel çalışıyorsa GPU belleği, bellek bant genişliği ve eşzamanlı istek kapasitesi günlük kullanım deneyimini doğrudan etkiler.
GPU belleğinde model ağırlıklarıyla birlikte bağlama ait KV cache için de yer gerekir. Bu ihtiyaç, uzun bağlam ve eşzamanlı isteklerle artabilir. Bu yüzden donanım seçimi model boyutu, sayısal hassasiyet, bağlam uzunluğu ve kullanıcı sayısıyla birlikte yapılmalıdır. Bellek ve bağlam planlamasında NVIDIA’nın LLM çıkarım rehberindeki yöntemler temel alınabilir.
Masaüstünde model ve harness denemeleri yapan bir geliştiriciyle, ortak model servisini kullanan bir ekibin kapasite ihtiyacı farklıdır. DGX Spark sınıfındaki sistemlerden GPU sunucularına uzanan seçenekleri değerlendirirken bu ayrım yol gösterir. OpenZeka’nın yapay zeka altyapı çözümleri, denemeden ekip kullanımına geçişte altyapının iş yüküne göre planlanmasını sağlar.
Seçimi Kendi İş Yükünüzle Yapın
Leaderboard, denenecek harness’ları belirlemek için bir başlangıç sunuyor. Sonraki adım, aynı modelle kendi hata düzeltme ve geliştirme görevlerinizi çalıştırmak; başarıyı, süreyi ve kaynak tüketimini birlikte ölçmek. Yerel kurulumda bu karşılaştırmaya donanım maliyeti ve kullanım oranı da eklenmeli. Model bağlantısı için gereken uyarlamalar ve kullanılan harness sürümleri, çalışmanın yöntem bölümünde belirtiliyor.
OPENZEKA HABERLERİ
OPENZEKA HABERLERİ
Hesaplarınızda paylaşmak ister misiniz?