DeepSeek-V4.1-Flash, 552 milyar parametrelik bir omurgaya sahip, çok modlu bir Mixture-of-Experts (MoE) modelidir. Hugging Face checkpoint’i 763 milyar parametre içerir: 552B omurga + 196B Engram koşullu bellek + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli. MXFP8 dense + MXFP4 expert ağırlık nicelemesi ve FP4 (E2M1) KV önbelleği ile gelir; 1 milyon token’a kadar bağlam destekler.
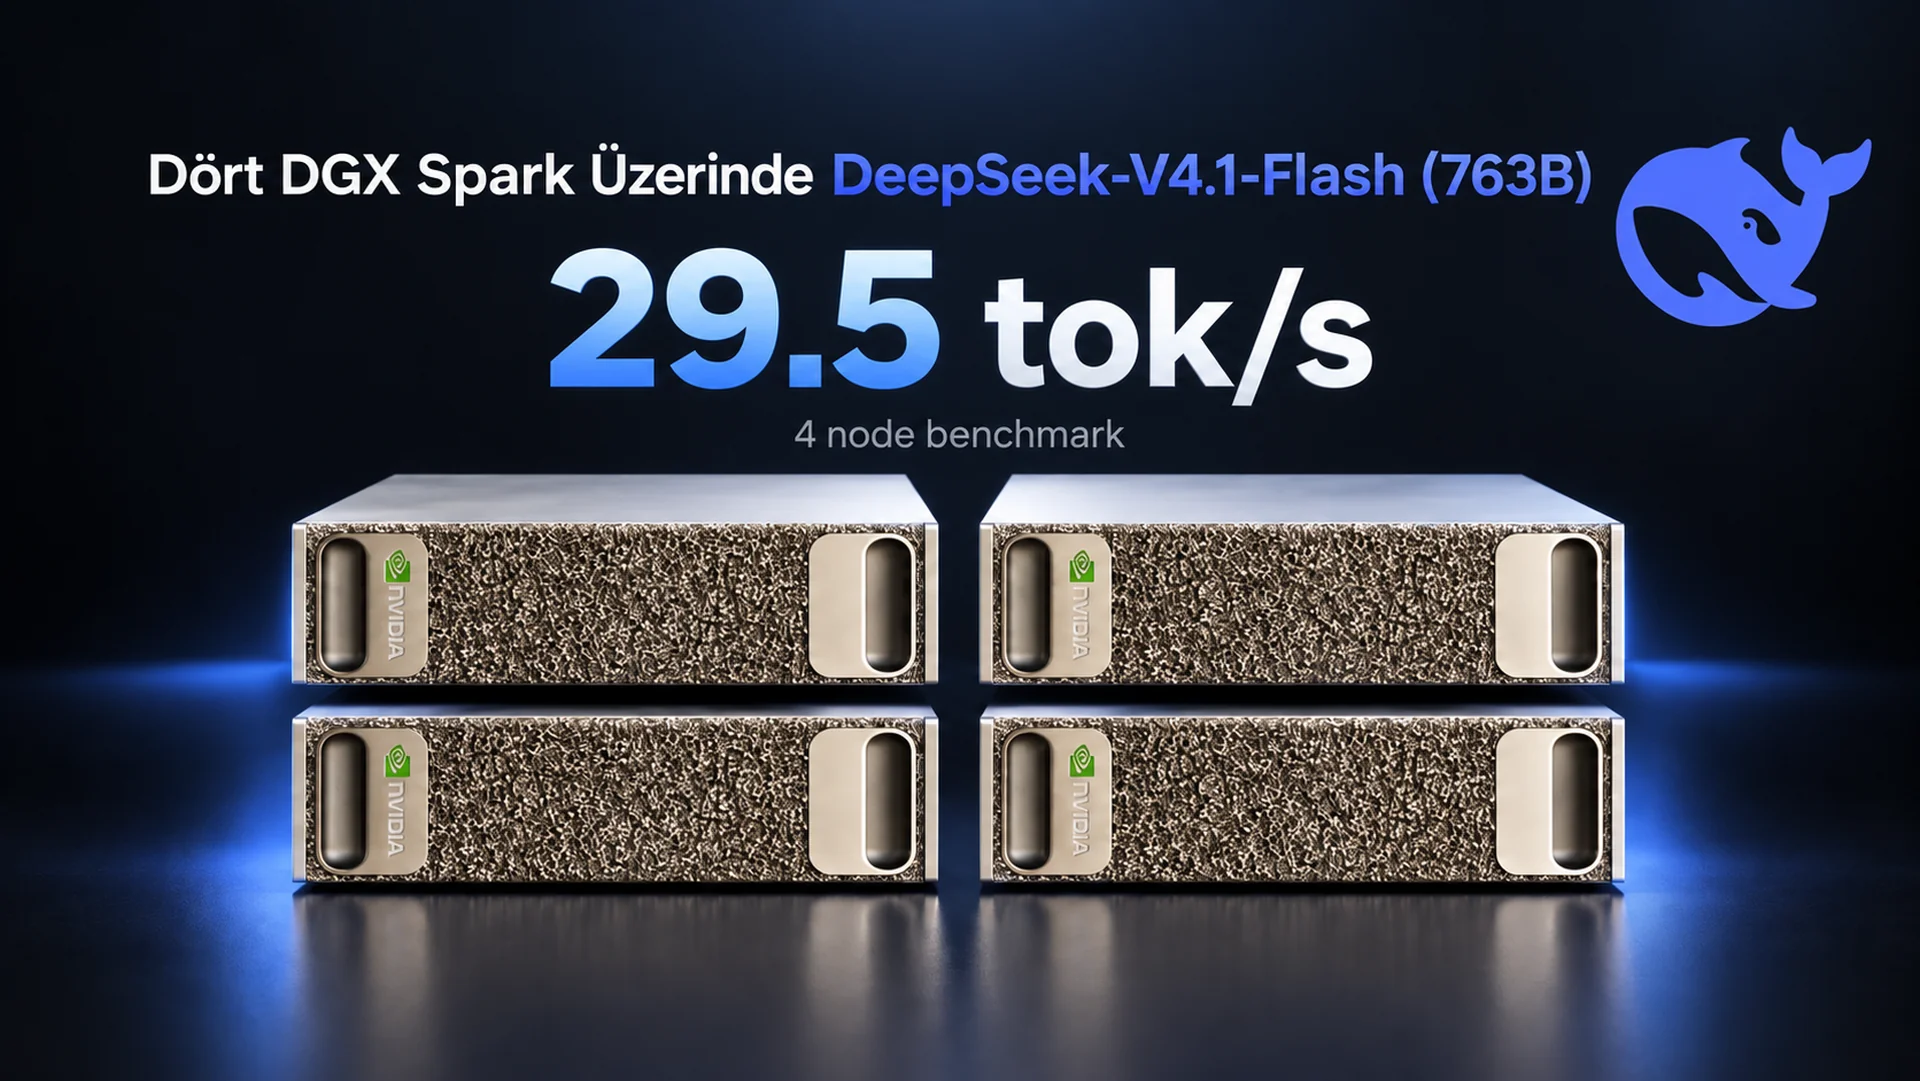
Bu model normalde DGX-B300 / GB300 NVL72 sınıfı veri merkezi donanımında servis edilir. Bu eğitimde ise onu, toplam 512 GB birleşik belleğe sahip dört DGX Spark’tan oluşan bir küme üzerinde çalıştıracağız. Bu dağıtım; dört düğümlü tensor parallelism (TP=4), Engram-on-disk modu ve DSpark speculative decoding sayesinde mümkün oluyor. Ulaşacağımız sonuç: tek eşzamanlılıkta (C=1) saniyede 29.5 token üretim hızı.
Not: Bu çalışma bir benchmark karşılaştırması değil, bir dağıtım rehberidir. Ölçümler dört veri noktasıyla sınırlıdır; yine de bu donanım sınıfının neler yapabildiğini göstermesi açısından değerlidir.
Spark, monitör ve klavye bağlayarak doğrudan bilgisayar olarak kullanılabileceği gibi, başka bir bilgisayarla uzaktan bağlanılan bir sunucu olarak da kullanılabilir. Biz bu eğitimde Spark’lara uzaktan bağlanacağız ve gerekli yazılımları kurup modeli çalıştıracağız.
Çıkarım motoru olarak vLLM, yönetim aracı olarak sparkrun kullanacağız. vLLM, modelin ağırlıklarını dört düğüme dağıtıp dışarıdan istek kabul eden bir API sunacak. sparkrun ise komut satırı üzerinden Docker konteynerlerini ve Spark’lar arasındaki model dağıtımını yönetecek; imaj senkronizasyonu, model aktarımı ve küme yapılandırması gibi işlemler otomatik olacak. vLLM’in stock nightly imajı, GB10 (SM 12.1a) için gerekli kod yollarını içermediğinden bu eğitimde yedi patch içeren özel bir imaj kullanacağız.
Bu eğitim beş bölümden oluşur:
Model ve Mimari: DeepSeek-V4.1-Flash’ı bu donanıma sığdıran mimari özellikler
Kurulum: Docker imajının hazırlanması ve recipe oluşturma
Çalıştırma: Modeli dört Spark üzerinde başlatma, izleme ve test etme
Benchmark: Farklı eşzamanlılık seviyelerinde performans ölçüm sonuçları
Kapatma: Servislerin durdurulması
Eğitim boyunca ana cihaza Main Spark, diğer üç cihaza ise Worker Spark denileceğini unutmayın.
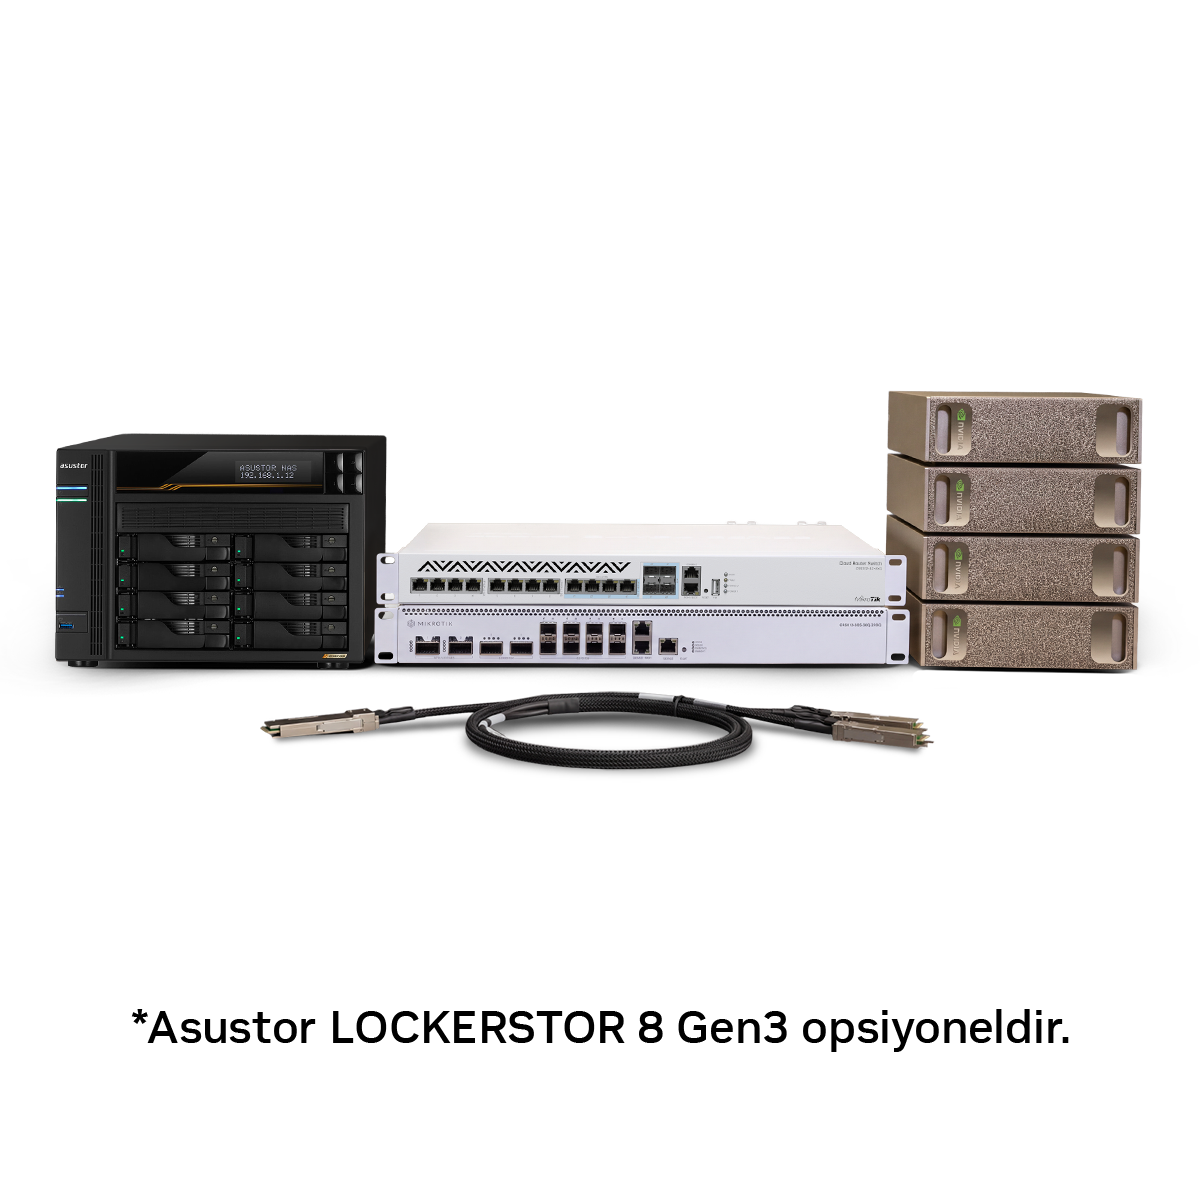
Model ve Mimari
DeepSeek-V4.1-Flash, önceki nesillere kıyasla KV önbellek ayak izini dramatik biçimde küçülten bir mimari sunar. Modelin öne çıkan özellikleri şunlardır:
- Omurga parametreleri: 552B
- Toplam checkpoint parametreleri: 763B (552B omurga + 196B Engram + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli)
- Aktif parametre (prefill / decode): 8B / 16B
- Engram koşullu bellek: 196B — token tabanlı lookup ile seyrek erişim
- Paylaşılan / yönlendirilen expert: 1 / 384 (token başına 6 aktif)
- Maksimum bağlam: 1.000.000 token
- Ağırlık nicelemesi: MXFP8 dense + MXFP4 experts (block 32×32, ue8m0 scale)
- KV önbellek nicelemesi: FP4 (E2M1, runtime — CSA2 mimari özelliği)
- Checkpoint boyutu: 510 GB (48 safetensors dosyası)
Causal Encoder-Decoder (CED)
Model, 40 katmanlı bir Transformer olup 20 katmanlı causal encoder + 20 katmanlı decoder olarak yapılandırılmıştır. CED’nin temel avantajı şudur: decoder’ın global KV önbelleği, her decoder katmanının kendi hidden state’inden değil, encoder’ın son hidden state’inden türetilir. Bu sayede prefill sırasında yalnızca 8B, decode sırasında 16B parametre aktive edilir.
SWA Bounded Replay ise Sliding Window Attention (SWA) KV state’lerini kalıcı SSD’ye yazmak yerine yalnızca en son n_win token’ı yeniden işleyerek eksik state’leri yeniden inşa eder. Bu, DeepSeek-V4-Flash’a kıyasla kalıcı KV önbellek ayak izini yaklaşık 1/8’e indirir.
Compressed Sparse Attention 2 (CSA2)
CSA2, her attention katmanına üç statik moddan birini atar: Full, Reindex veya Reuse. Bu modlar ana KV ve indexer K’yı katmanlar arasında paylaşır ve Top-K sparse-attention indekslerini yeniden kullanır. Decoder’da bir Hierarchical Sparse Indexer, daha sonraki indeksleme katmanlarını ilk Full Mode katmanının oluşturduğu aday havuzuyla sınırlar; böylece daha derin indeksleme maliyeti bağlam uzunluğundan bağımsız hâle gelir.
FP4 ana KV önbelleği (E2M1 formatı, 16 kanal başına bir E4M3 ölçeği) ile birleştiğinde global KV önbellek ayak izi token başına 890 byte’a iner — DeepSeek-V4-Flash’ın yaklaşık 1/4’ü.
Engram Koşullu Bellek
196B parametrelik Engram katmanı, token tabanlı lookup ile seyrek erişilir. Bu dağıtımda Engram-on-disk modu kullanılıyor: Engram satırları GPU belleğinde değil, her düğümün yerel diskinde tutulur ve ihtiyaç duyulduğunda GPU belleğine stage’lenir. 763B’lik modelin 4× 128 GB (512 GB toplam) birleşik belleğe sığmasını sağlayan temel bileşen budur.
DSpark Speculative Decoding
DSpark, yarı-otoregresif draft üretimi ve güvenlik tabanlı doğrulama ile çalışan bir speculative decoding mekanizmasıdır. Bu dağıtımda k=5 derinliği kullanılıyor: her decode adımında 5 token önceden tahmin edilir ve doğrulanır. Doğrulanan token’lar çıktıya eklenir, reddedilenler yeniden üretilir.
Bu çalışmayı belgelemeye değer kılan iki özellik var:
- Model, veri merkezi sınıfında: DeepSeek-V4.1-Flash normalde DGX-B300 / GB300 NVL72 sınıfı donanımda servis edilir. 4× DGX Spark, mimarinin ölçeklenebilir ucunu temsil eder.
- SM 12.1a’ya özgü patch’ler: Stock vLLM nightly imajında SM 12.1a (GB10) için eksik veya hatalı olan kod yolları — Engram-on-disk, FlashInfer sparse attention, SWA block size, attention page sizes — yedi topluluk patch’i ile düzeltilmiştir.
Kurulum
Önceki eğitimlerde Spark’a bağlanma, sparkrun kurulumu ve çoklu Spark küme yapılandırma süreçleri adım adım anlatıldı. Bu eğitimde tüm bu adımların yapılmış ve kurulumunuzun hazır olduğunu varsayıyoruz.
Bu eğitim 4 DGX Spark gerektirir. Ana cihaza <main-spark-ip>, diğer üç cihaza <worker-spark-ip-1>, <worker-spark-ip-2> ve <worker-spark-ip-3> diyeceğiz. Her cihazın IP adresini önceden not edin.
Dağıtımda kullanılan dört düğümün her biri şu özelliklere sahiptir:
- GPU: GB10 (SM 12.1a, 48 SM), ~1 PFLOP FP4 tepe (seyreklik ile)
- Bellek: 128 GB unified LPDDR5X (CPU+GPU paylaşımlı), ~273 GB/s bant genişliği
- CPU: 20 çekirdekli Arm (10× Cortex-X925 + 10× Cortex-A725)
- Düğümler arası: NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP)
- Depolama: 8× NVMe SSD (1× 1 TB + 7× 4 TB, dört düğüm genelinde)
- Ağ topolojisi: 200 GbE switch
Kritik nokta: DGX Spark’lar arasında NVLink yoktur. Bu dağıtımdaki TP=4, ConnectX-7 200 GbE ağı üzerinden çalışan multi-node tensor parallelism’dir — her all-reduce işlemi Ethernet switch’ten geçer. Dağıtık çalışmada GPU’lar sürekli veri alışverişi yaptığı için bu iletişim maliyeti performansı doğrudan etkiler.
1. Docker İmajını Hazırlama
vLLM’in stock nightly imajı, SM 12.1a (GB10) üzerinde DeepSeek-V4.1-Flash kod yollarında eksiklikler içerir. Bu yüzden, gereken düzeltmeleri içeren özel bir Docker imajı kullanacağız. İmaja gömülü yedi patch şunlardır:
- engram.py — Engram-on-disk, rank-offset düzeltmesi
- model_state.py — Forward öncesi Engram staging (CUDA graph uyumlu)
- weight_utils.py — Engram tablolarının yükleme sırasında atlanması
- attention.py — SM 12.1a attention sayfa boyutları
- flashinfer_sparse.py — 64-state sayfalar
- sparse_swa.py — SWA block size kancası
- sparse_attn_indexer.py — SM 12.1a top_k_per_row_decode
OpenZeka tarafından hazırlanan Docker imajını indirmek için şu komutu çalıştırın:
İmajı doğrulayın:
İmajı Sıfırdan Build Etmek İsterseniz
İmaj, base olarak vLLM’in nightly imajını kullanır ve beş overlay katmanı ile bir patch katmanından oluşur:
- Base imaj:
vllm/vllm-openai:nightly-8a728663c1c3eeace834a95f5654fa653cc1998c - vLLM branch:
build/fetch_vllm_branch.shile checkout edildi (commite47aa780b) - Kaynak repo:
tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark(boot10 config)
Build zincirinin özeti:
- C extension —
_C_stable_libtorch+_moe_C_stable_libtorch, SM 12.1a için derlendi (build_stable_ext.shilev41buildcontainer’ında) - overlay1 — Base imaj + vLLM branch tree (
vllm/vllm/) + 2 adet .so - overlay3 — FlashInfer 0.7.0rc1 derlendi
- overlay4 — CUTLASS mxfp8_gemm_sm120 prebuilt
- overlay5 — sparse_mla_sm120 prebuilt + verify
- patch layer — 7 patch dosyası imaja gömüldü +
ENTRYPOINT []eklendi
Tüm komutlar head node’da (Main Spark) çalıştırılır. Önce repo klonlanır ve vLLM branch’i checkout edilir:
Ardından C extension’lar derlenir:
Overlay katmanları sırayla inşa edilir:
Son katman, yedi patch dosyasını imaja kopyalayıp ENTRYPOINT [] ekleyen patch layer’dır. Dockerfile’da COPY vllm/vllm/ (vllm/ değil) kullanılmasına dikkat edilmelidir — vllm/ bir git repo olup Python paketi vllm/vllm/ altında bulunur. İmaj şu komutla oluşturulur:
Ortaya çıkan imaj: vllm-dsv41:latest (33.8 GB).
Build sonrası iki optimizasyon uygulandı: OMP_NUM_THREADS=1 reçeteye eklendi (spin-wait çekişmesini azaltır) ve build kalıntıları (overlay’ler, base imaj, build cache — yaklaşık 258 GB) temizlendi.
sparkrun imajı başlatma sırasında dört düğüme otomatik olarak dağıtır; imaj zaten mevcut olan düğümleri atlar. Dilerseniz Worker’larda da aynı docker pull komutunu çalıştırabilirsiniz. Alternatif olarak manuel dağıtım:
2. Recipe Hazırlama
Recipe, sparkrun’ın modeli nasıl çalıştıracağını tanımlayan bir YAML dosyasıdır. Model, Docker imajı, vLLM bayrakları ve bellek ayarları tek dosyada toplanır. DeepSeek-V4.1-Flash için bu recipe, dört düğümde tensor parallelism (TP=4) kullanır, Engram-on-disk modunu etkinleştirir ve DSpark speculative decoding (k=5) ile çıkarımı hızlandırır.
Aşağıdaki komutu kullanarak recipe dosyasını kaydedin:
Dosyayı doğrulayın:
Kaydettiğiniz recipe dosyasını göreceksiniz.
Reçetedeki kritik parametreler (test kümesinde kullanılan değerler):
- tensor_parallel: 4 — 4 düğüm × 1 GPU
- gpu_memory_utilization: 0.80 — %80 GMU
- max_model_len: 300000 — 1M bağlamın altında; bellek kısıtı nedeniyle 300K
- max_num_seqs: 8 — maksimum 8 eşzamanlı dizi
- max_num_batched_tokens: 8192 — prefill batch boyutu
- block_size: 128 — KV önbellek blok boyutu
- distributed-executor-backend: mp — multiprocess backend
Speculative Decoding (DSpark)
DSpark k=5 derinliği ile her decode adımında 5 token önceden tahmin edilir:
Engram-on-disk Yapılandırması
Engram satırları diskte tutulur, 32 thread ile paralel okunur ve 16’lık chunk’lar hâlinde GPU belleğine stage’lenir:
Servis Parametreleri
Model, düşünme modu kapalı, araç çağırma ve çok modlu (görüntü) desteği açık olarak servis edilir:
- Düşünme modu: kapalı —
--default-chat-template-kwargs '{"thinking": false}' - Araç çağırma: açık —
--tool-call-parser deepseek_v41+--enable-auto-tool-choice - Reasoning parser:
--reasoning-parser deepseek_v41 - Çok modlu girdi:
--limit-mm-per-prompt '{"image":4}'— prompt başına en fazla 4 görüntü - CUDA graphs:
--compilation-configile FULL_AND_PIECEWISE modu
Çalıştırma
3. Başlatma Öncesi Kontroller
sparkrun’ın recipe’yi doğru ayrıştırdığını ve bellek bütçesinin uygun olduğunu doğrulayın:
sparkrun, recipe’yi doğru ayrıştırdı; vllm-distributed runtime’ını seçti ve “DGX Spark fit: YES” onayını verdi.
Şimdi başlatma planını önizleyin:
Dry run başarılı: reçete geçerli, “Mode: cluster (4 nodes)” görüldü ve serve command’taki tüm bayraklar çözümlendi.
Engram-on-disk modunda her rank (düğüm), Engram satırlarının farklı bir aralığını kendi yerel diskinde tutar. Test kümesinde toplam ~384 milyon satır dört rank’a eşit bölünmüştü; örnek olarak Layer 1 ve Layer 14 aralıkları:
- Rank 0 (Main Spark): Layer 1 → [0, 96000564) · Layer 14 → [0, 96003054)
- Rank 1: Layer 1 → [96000564, 192001740) · Layer 14 → [96003054, 192007016)
- Rank 2: Layer 1 → [192001740, 288003654) · Layer 14 → [192007016, 288011564)
- Rank 3: Layer 1 → [288003654, 384006168) · Layer 14 → [288011564, 384016682)
Dört düğümde de Docker imajının hazır olması gerekir; sparkrun başlatma sırasında imajı otomatik senkronize eder (aynı ID ise atlar). Manuel dağıtım için 1. adımdaki docker save komutlarını kullanabilirsiniz. Aynı şekilde model dosyalarının da head node’un Hugging Face cache’inde hazır olması gerekir: reçete HF_HUB_OFFLINE=1 ve TRANSFORMERS_OFFLINE=1 ile çalışır, dağıtım sırasında Hugging Face’ten indirme yapılmaz. Test kümesinde model dosyaları DGX-B300’den Spark head node’a aktarılmıştı.
4. Modeli Başlatma
Şimdi modeli başlatalım:
sparkrun otomatik olarak imajı dört düğüme senkronize eder, model dosyalarını (checkpoint 510 GB) head node’dan Worker’lara dağıtır, NCCL yapılandırmasını CX-7 arayüzleri için ayarlar ve her Spark’ta konteyner başlatır. --foreground bayrağıyla dağıtım süreci terminalden izlenir; Ctrl+C ile ayrılsanız bile iş yükü çalışmaya devam eder. İlk senkronizasyon, checkpoint boyutu nedeniyle ağ hızınıza bağlı olarak uzun sürebilir. Başarılı bir başlatmanın çıktısı, 3. adımdaki dry-run önizlemesiyle aynı yapıyı izler; gerçek çalıştırmada ek olarak imaj ve model senkronizasyonunun süreleri ile runtime sürümleri (CUDA, NCCL, Python, torch, vLLM) listelenir.
5. Başlangıç Sürecini İzleme
Model dosyaları senkronize edildikten sonra servisin hazır hâle gelmesi birkaç dakika alabilir. Bu süreçte model ağırlıkları dört düğümde GPU belleğine yüklenir, Engram-on-disk staging devreye girer, DSpark draft modeli başlatılır ve CUDA grafikleri yakalanır.
vLLM loglarını izlemek için:
vLLM tabanlı tüm dağıtımlarımızda olduğu gibi, sunucu hazır olduğunda “Application startup complete.” satırını görürsünüz. Ctrl+C ile log izlemeyi durdurabilirsiniz; sunucu arka planda çalışmaya devam eder.
6. Modeli Test Etme
Öncelikle sunucunun çalıştığını doğrulayın:
“HTTP 200” yanıtı sunucunun sağlıklı olduğunu gösterir. Şimdi kayıtlı modelleri listeleyin:
Listede deepseek-v4.1-flash modelini göreceksiniz. Son olarak modelle basit bir test yapın:
Yanıt olarak modelin 1’den 10’a kadar sayması beklenir. DeepSeek-V4.1-Flash şu an çalışıyor ve Main Spark’ın 8000 portundan servis sağlıyor. Dilerseniz modeli bir web arayüzü (ör. Open WebUI) veya ajan mimarisiyle (ör. OpenCode) kullanabilirsiniz.
Benchmark
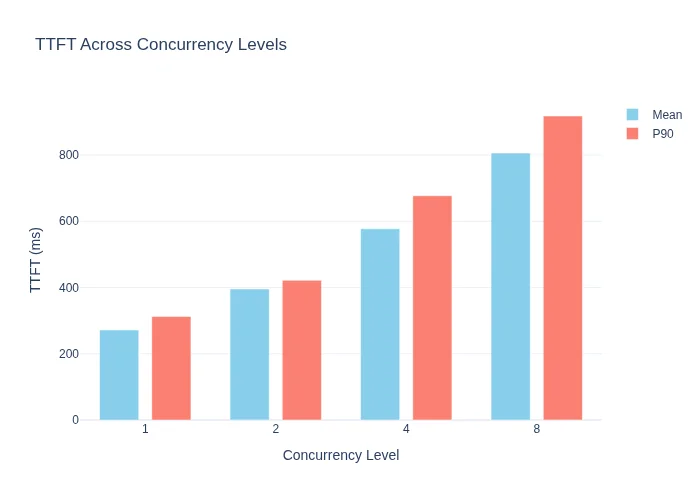
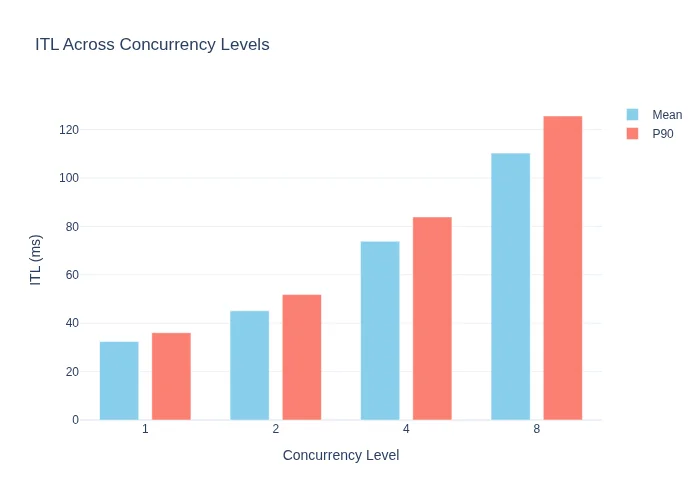
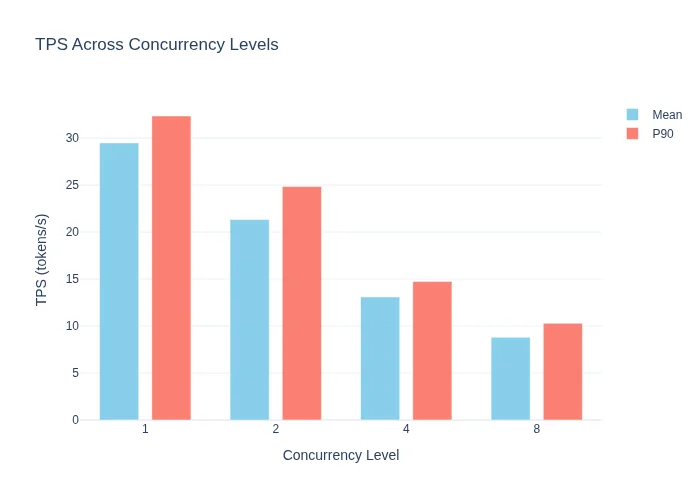
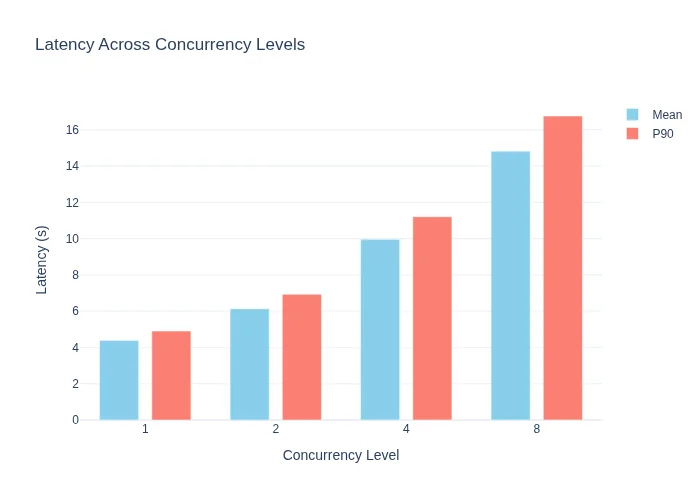
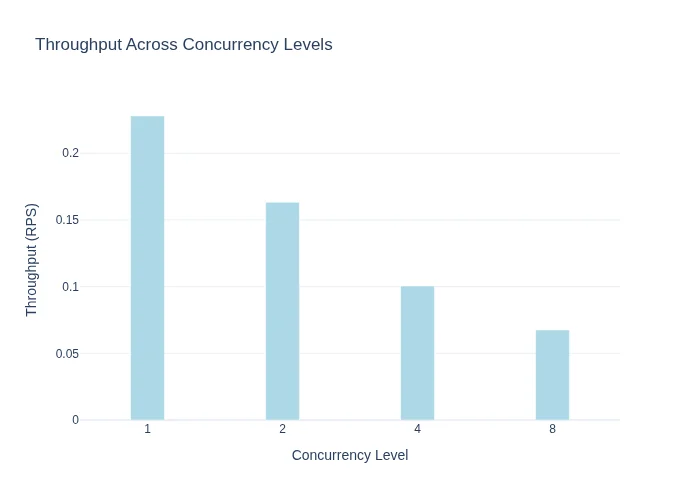
Dört Spark üzerinde çalışan DeepSeek-V4.1-Flash modelini, farklı eşzamanlılık (concurrency) seviyelerinde test ettik. Ölçümler, CordatusAI LLM Benchmark Tool kullanılarak alınmıştır (JIT ısınması sonrası ikinci çalıştırma). Kaydedilen değerler: TTFT (Time to First Token — ilk token’ın üretime başlama süresi), ITL (token’lar arası süre), TPS (saniye başına üretilen token sayısı), gecikme ve throughput.
- Eşzamanlılık 1 — TTFT ort.: 271.63 ms · ITL: 32.39 ms · TPS ort.: 29.48 tok/s · Gecikme: 4.39 s · Throughput: 0.23 RPS
- Eşzamanlılık 2 — TTFT ort.: 395.75 ms · ITL: 45.12 ms · TPS ort.: 21.32 tok/s · Gecikme: 6.13 s · Throughput: 0.16 RPS
- Eşzamanlılık 4 — TTFT ort.: 577.41 ms · ITL: 73.86 ms · TPS ort.: 13.09 tok/s · Gecikme: 9.96 s · Throughput: 0.10 RPS
- Eşzamanlılık 8 — TTFT ort.: 805.89 ms · ITL: 110.28 ms · TPS ort.: 8.79 tok/s · Gecikme: 14.81 s · Throughput: 0.07 RPS
C=1’de 29.5 tok/s, interaktif kullanım için yeterli bir hızdır; okuma hızı (~15 tok/s) eşiğinin üzerindedir. TTFT, eşzamanlılık artışıyla beklenen biçimde yükselir (272 → 806 ms, ~3x) — prefill aşaması hesaplama sınırlıdır (compute-bound). TPS düşüşü ise GPU’nun doygunluğa yaklaşmasıyla bellek bant genişliği çekişmesinin artmasından kaynaklanır (29.5 → 8.8 tok/s, ~%70 düşüş).
Benchmark Gezgini’nin varsayılan hedefleri (TTFT ≤ 1000 ms ve TPS ≥ 15 tok/s) baz alındığında bu yapılandırma Max C = 2 değerini verir:
- TTFT ≤ 1000 ms — C=2 durumu: 396 ms ✓
- TPS ≥ 15 tok/s — C=2 durumu: 21.32 tok/s ✓
Uyarı: C=4’te TPS 13.09’a düşerek 15 tok/s eşiğinin altına iner. Bu nedenle interaktif sohbet servisleri için 1-2 eşzamanlı kullanıcı önerilir; daha yüksek yük için veri merkezi donanımı (B300/GB300) tercih edilmelidir.
Bu araç, CordatusAI tarafından geliştirilen ve OpenAI uyumlu API’lere sahip LLM sunucularını test eden bir benchmarking uygulamasıdır. Aşağıda benchmark grafiklerini görebilirsiniz:
DSpark Acceptance
DSpark speculative decoding’in etkinliği, kabul oranı (acceptance) ve draft hızı (draft rate) ile ölçülür:
- Prose (bench) prompt’ları — Ortalama acceptance: 2.1–2.3 · Draft rate: %22
- Kodlama prompt’ları — Ortalama acceptance: 4.9–5.3 · Draft rate: %80–86
Kodlama prompt’larında DSpark k=5’in acceptance oranının yüksek olması (4.9–5.3 / 5), kodun tekrarlı yapısından kaynaklanır.
DGX-B300 ile Karşılaştırma
Aynı model, LLM Çıkarım Benchmark Gezgini üzerinde DGX-B300 (8× Blackwell Ultra, TP=4) ile de ölçülmüştür. B300 satırı modeli farklı parametrelerle servis eder: DSpark k=3 (bu çalışmadaki k=5 yerine) ve 1M bağlam (300K yerine).
Saniye başına token üretimi (tok/s):
- Eşzamanlılık 1 — 4× Spark: 29.48 · B300: 284.54 · Oran: 9.65×
- Eşzamanlılık 2 — 21.32 · 294.56 · 13.82×
- Eşzamanlılık 4 — 13.09 · 252.60 · 19.30×
- Eşzamanlılık 8 — 8.79 · 209.41 · 23.83×
B300, C=1’de ~9.65× daha hızlıdır. Bu fark beklenendir ve iki donanım sınıfı arasındaki temel farklardan kaynaklanır:
- GPU belleği: HBM3e (~8 TB/s) — LPDDR5X unified (273 GB/s); bant genişliği oranı ~1/30
- GPU interconnect: NVLink — ConnectX-7 200 GbE RDMA
- GPU başına SM: 148 (B200) — 48 (GB10)
- FP4 tepe: ~9 PFLOP — ~1 PFLOP
Sonuç: 4× DGX Spark, 763B’lik bir veri merkezi modelini çalıştırabilir — ancak veri merkezi donanımının yerini almaz. Bu yapılandırma; geliştirme, prototipleme ve sınırlı kullanıcı sayılı production senaryoları için uygundur.
Kapatma
İşiniz bittiğinde modeli durdurun:
Bu komutla dört düğümdeki konteynerler durdurulur ve bellek alanı boşalır. Ama konteyner, Docker imajı ve model dosyaları diskte kalır. Böylelikle tekrar başlatmak için yeniden indirme yapmanız gerekmez; 4. adımdaki sparkrun run komutunu tekrar çalıştırmanız yeterli.
Sonuç
763 milyar parametreli DeepSeek-V4.1-Flash, dört DGX Spark üzerinde çalıştırılabilir — bu, ofis dostu mini süper bilgisayarların ulaştığı ölçeklenebilirliğin bir göstergesidir. Ancak bunun bedeli ve sınırları var:
- Yedi SM 12.1a patch’i zorunludur — stock vLLM nightly imajı, GB10 (SM 12.1a) için Engram-on-disk, FlashInfer sparse attention ve SWA kod yollarında eksiklikler içerir.
- Engram-on-disk, modelin belleğe sığmasını sağlar — 196B’lik koşullu bellek diske taşınarak 763B’lik modelin 512 GB toplam birleşik belleğe sığması mümkün olur.
- DSpark k=5, kodlama prompt’larında %80-86 draft hızı ile etkindir; prose prompt’larında bu oran %22’ye düşer.
- C=1’de 29.5 tok/s, geliştirme ve prototipleme için yeterlidir; production servis için B300 sınıfı donanım ~10× daha hızlıdır.
Bu yapılandırma bir veri merkezi alternatifi değil, bir geliştirme platformudur. 763B’lik bir modelin ofis donanımında çalışabilmesi, edge ve on-premises deployment senaryolarının sınırlarını gösteriyor.
Bu dağıtımın tüm teknik ayrıntıları — build zinciri, yedi patch’in içeriği, Engram satır aralıkları, ham ölçümler ve doğrulama komutları — DeepSeek-V4.1-Flash 4× DGX Spark Dağıtımı whitepaper’ında yer alıyor.
OPENZEKA HABERLERİ
Tavsiye Edilen Ürünler
OPENZEKA HABERLERİ
Hesaplarınızda paylaşmak ister misiniz?